<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom" xml:lang="zh_CN">
  <title>林曦屿</title>
  <subtitle>记录生活与热爱</subtitle>
  <link href="https://www.lxii.cc/" rel="alternate" type="text/html"/>
  <link href="https://www.lxii.cc/atom.xml" rel="self" type="application/atom+xml"/>
  <id>https://www.lxii.cc/</id>
  <updated>2026-10-21T01:40:00.000Z</updated>
  <entry>
    <title>DeepSeek 把压箱底的推理引擎开源了，硅谷为什么不跟</title>
    <link href="https://www.lxii.cc/posts/deepseek-deepinfer-open-source-2026/" rel="alternate" type="text/html"/>
    <id>https://www.lxii.cc/posts/deepseek-deepinfer-open-source-2026/</id>
    <published>2026-10-21T01:40:00.000Z</published>
    <updated>2026-10-21T01:40:00.000Z</updated>
    <summary>10 月 20 日，DeepSeek 开源了生产推理框架 DeepInfer。它开的是引擎，没开的是运营；硅谷不跟，也不是因为小气。</summary>
    <content type="html"><![CDATA[<h1>DeepSeek 把压箱底的推理引擎开源了，硅谷为什么不跟</h1>
<p>10 月 20 日，DeepSeek 把 DeepInfer 扔上了 GitHub，Apache 2.0。没有发布会，没有预热，跟去年 2 月那次开源周一个路数：一天一个仓库，扔完就走。</p>
<p>先说结论：这次开源的重量不在代码，在它顺手公开的那组运营数字。代码可以读，数字抄不走。</p>
<h2>开的是生产引擎，不是 demo</h2>
<p>README 第一句：这套东西在跑 DeepSeek 自己的大规模生产服务。</p>
<p>但它不是给人下载来玩的。只支持一个模型，V4.1-Flash；只支持两种硬件，NVIDIA SM100 和华为昇腾 950；要 CUDA 13 或 CANN 9.2，Python 3.12。官方 Q&amp;A 写，最小的高效部署单元是 64 卡 prefill 加 64 卡 decode。</p>
<p>128 张 Blackwell。个人开发者看到这行可以关页面了。</p>
<p>它服务的对象很清楚：有卡、有集群、缺引擎的云厂商和大型推理团队。</p>
<h2>开到了哪一层</h2>
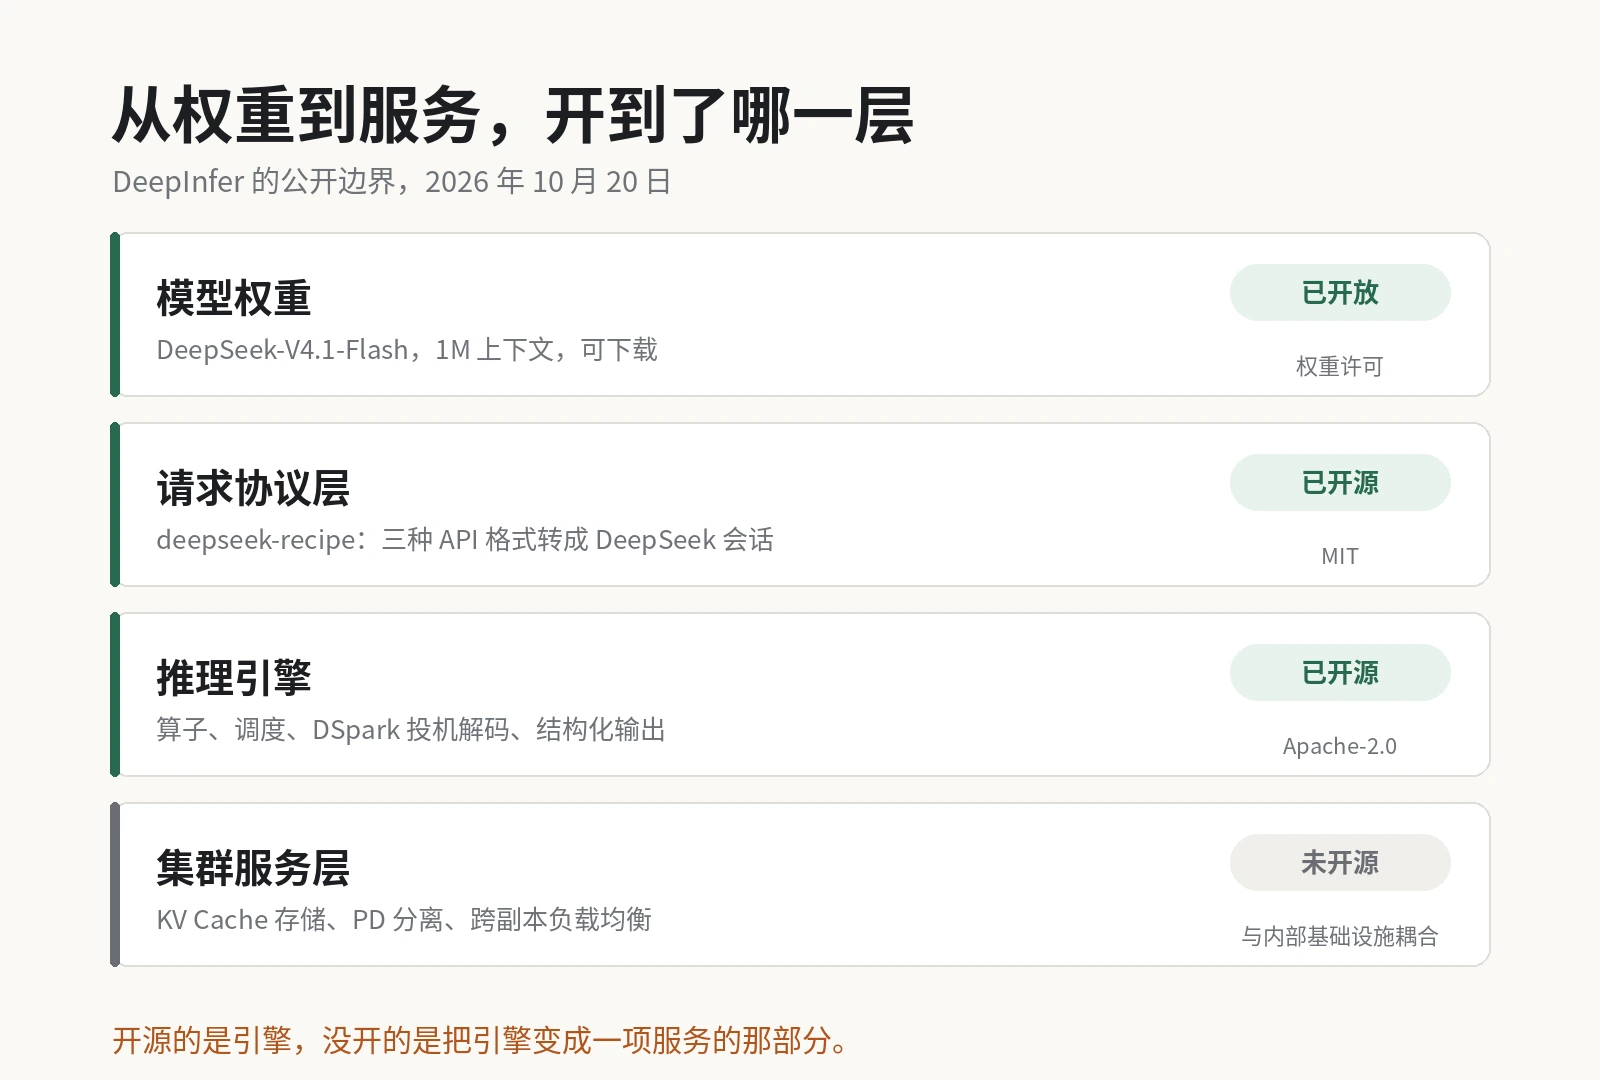
<p><img src="/images/posts/deepinfer/layers.webp" alt="从权重到服务的四层，开源边界在哪 w-100%" title="图 1：DeepInfer 的公开边界。引擎和协议层开源，KV Cache、PD 分离、负载均衡没有。" /></p>
<p>一起放的还有 deepseek-recipe，MIT 许可。它管请求怎么变成 token：Chat Completions、Responses、Messages 三种格式进来，统一成 DeepSeek 的会话，再把输出解析回去，包括思考内容、工具调用、图片。</p>
<p>两个许可都是宽松型，允许商用，也允许改了之后闭源。DeepSeek 没选 copyleft，等于放弃用许可证逼别人回馈。它要的是扩散速度，不是控制权。</p>
<p>两件事放一起看，边界就清楚了。模型权重早就开了，请求协议层这次开了，推理引擎这次开了。没开的是 KV Cache 存储、PD 分离的编排、跨副本负载均衡。</p>
<p>Q&amp;A 里的原话是，这几块跟内部基础设施绑得太紧，“not yet fully open-sourced”。注意 yet。</p>
<p>翻译一下：它给你“把模型跑快”的能力，不给“把服务跑起来”的能力。前者是技术，后者是运营。技术可以送，运营不能送。</p>
<p>公开版还只是 offline inference。想拿它直接对外提供在线 API，中间那套得自己补。</p>
<p>这里有个容易被忽略的点：代码公开，不等于服务可以复现。那 100 PiB 的缓存怎么分层、哪些 prefix 值得留、什么时候淘汰、跨机房怎么调度，这些决策不在仓库里。参数可以照抄，判断不能。</p>
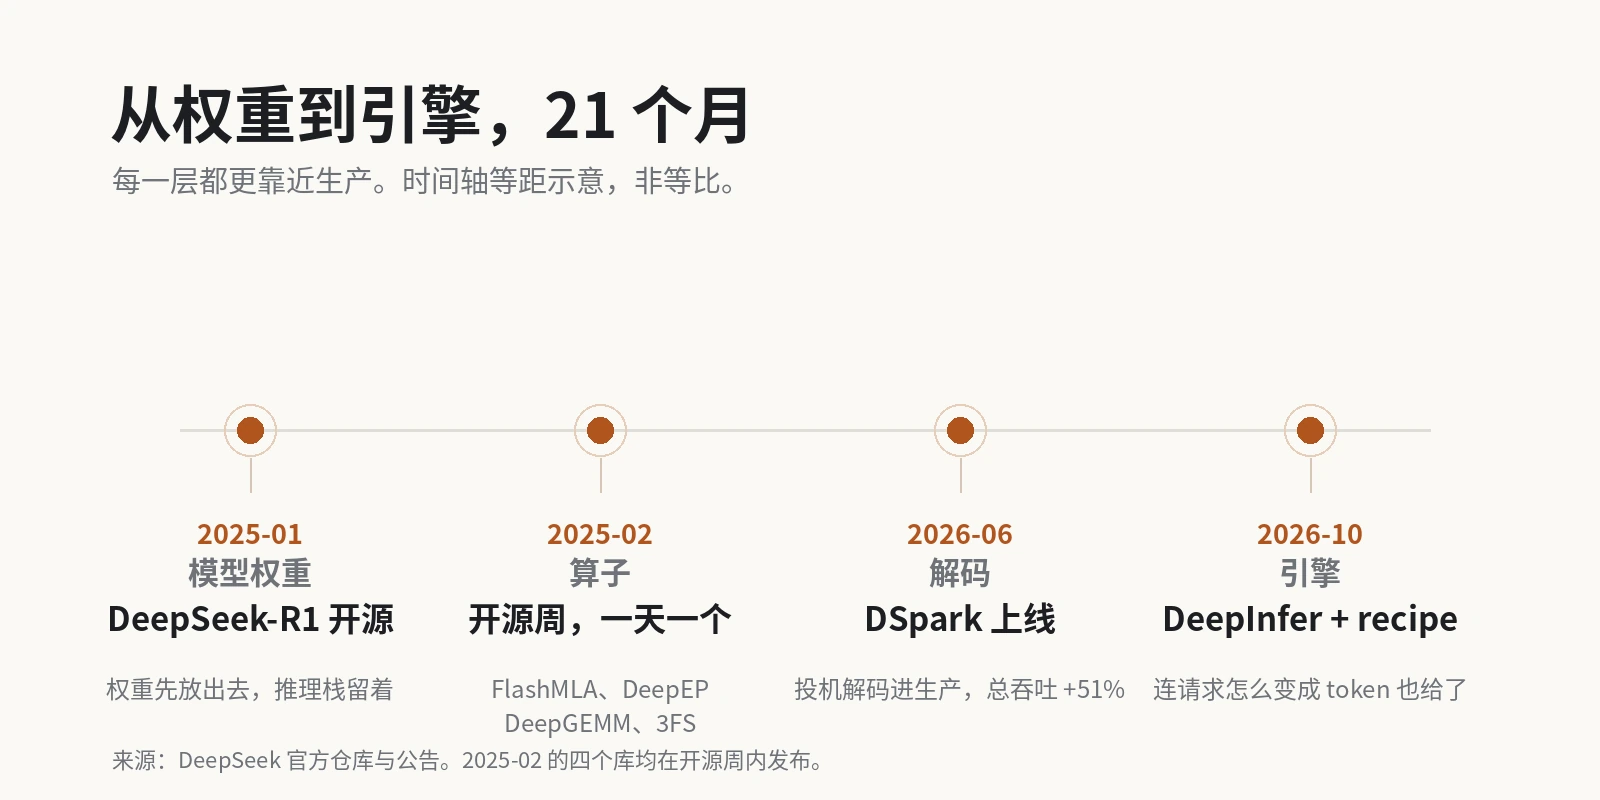
<p>这不是一次性的动作。从权重到算子，再到引擎和协议层，DeepSeek 一层层往下开了 21 个月。</p>
<p><img src="/images/posts/deepinfer/timeline.webp" alt="DeepSeek 开源时间线 w-100%" title="图 2：从 2025 年 1 月的 R1 权重，到 2026 年 10 月的生产引擎。时间轴等距示意。" /></p>
<h2>比代码值钱的是数字</h2>
<p>Q&amp;A 第一次公开了生产数据：</p>
<table>
<thead>
<tr>
<th>指标</th>
<th>数值</th>
</tr>
</thead>
<tbody>
<tr>
<td>单集群吞吐</td>
<td>155 万亿 token/天</td>
</tr>
<tr>
<td>单卡收入</td>
<td>约 38 美元/GPU·小时（谷时价）</td>
</tr>
<tr>
<td>平均首字延迟</td>
<td>400 ms</td>
</tr>
<tr>
<td>生成速度</td>
<td>230 tok/s，代码场景 300 tok/s</td>
</tr>
<tr>
<td>输入缓存命中率</td>
<td>96%</td>
</tr>
<tr>
<td>KV Cache 存储</td>
<td>约 100 PiB SSD</td>
</tr>
<tr>
<td>每张在线 GPU 的逻辑缓存</td>
<td>约 14.4 TB</td>
</tr>
</tbody>
</table>
<p>38 美元是谷时电价下的口径，是下限。按 128 卡算，一小时 4864 美元。155 万亿 token 一天，折下来每秒约 18 亿 token。做推理生意的人看到这两个数，心里的秤就能校准。</p>
<p>还有两个细节。</p>
<p>缓存保留策略：agent 流量留 3 天，chatbot 流量留 7 天。因为 chatbot 的命中有一个很长的尾巴，少量缓存会被反复读很多次。这种经验不会写进论文。</p>
<p>公开版和内部版的差距：公开的 FlashMLA 少了一个手工调优，decode kernel 慢 5% 到 10%，端到端最多差 5%。这话很诚实，也说明真正拉开差距的，往往就是那一两个手调 kernel。</p>
<p>以上都是厂商口径，没有第三方复测。但愿意把每 GPU 小时收入写出来的公司，不多。</p>
<h2>硅谷为什么不跟</h2>
<p>先排除一个偷懒的解释：不是不会，也不是没东西可开。</p>
<p>OpenAI 去年开过 gpt-oss 的权重，Apache 2.0，单卡能跑。那是“让你在本地试试我们的模型”，不是“让你用我们的生产方式”。Anthropic 连权重都没开过。Meta 开了 Llama 权重，也没开生产栈。</p>
<p>Google 其实开过推理引擎。JetStream，跑在 XLA 设备上，Apache 2.0。今年 2 月 1 日归档，核心功能并进 vLLM 的 TPU 后端。这个动作比任何声明都说明问题：连 Google 都觉得，单独维护一个开源推理引擎，不如把它塞进社区最大的那个池子。</p>
<p>所以“美国闭源、中国开源”是个省事的说法。vLLM、SGLang、PyTorch、TensorRT-LLM，这些开源基建大多是美国高校和公司起头的。真正的区别是：美国巨头不开自己的生产栈。</p>
<p>原因不复杂。对 OpenAI 和 Anthropic，推理栈是毛利。模型能力落后半年还能追，单位成本落后 30% 追不回来。延迟、上下文长度、工具调用稳定性，这些产品体验最后都落在同一套栈上。开源等于把成本曲线交给对手，还附一份调优说明书。</p>
<p>闭源也不是纯坏话。工具调用约束、结构化输出、拒答策略，有一部分就长在推理栈上。开出去，别人能照着做，也能研究怎么绕。对把安全当卖点的公司，这笔账很难算平。</p>
<p>DeepSeek 的账不一样。权重本来就开，API 价格本来就低。推理栈捂着，护城河也护不住多少；放开，所有卖 DeepSeek 模型的云厂商都会按它的最优解跑。省下的调优时间，会变成更多 V4.1-Flash 部署。</p>
<p>这不是慈善，是标准战。Android 那套，先让所有人用你的底座，再谈别的。</p>
<p>我的判断是，引擎变成公共品之后，云厂商之间能比的只剩卡、电价和运维。推理服务的毛利会被压薄，钱往上游走，去卖卡、卖电、卖机房的人那里。DeepSeek 自己不做公有云，它乐见其成。</p>
<p>时间点也挑过。V4.1-Flash 是 9 月 10 日发的，到开源这天，口碑和调用量都起来了，引擎放出去接得住。再晚两个月，模型热度下去，代码开出来也没多少人部署。</p>
<h2>昇腾那一行比 155 万亿更重</h2>
<p>Supported hardware 只有两行：NVIDIA SM100 GPUs，Huawei Ascend 950 NPUs。</p>
<p>我在这行停了一会儿。</p>
<p>CUDA 的护城河不是指令集，是十年攒下来的算子、调度、调优经验。一颗新芯片最难的不是流片，是让框架作者愿意为它写 kernel，让云厂商相信它跑得稳。</p>
<p>一个生产级引擎把 SM100 和 Ascend 950 放在同一层抽象里，等于告诉所有用昇腾的人：你不用等一个国产推理框架慢慢成熟，DeepSeek 的生产引擎已经在你这边跑通了。</p>
<p>对英伟达不是好消息，对昇腾是，对开发者是多一个选择。虽然这个选择目前只支持一个模型。</p>
<p>能不能真跑起来，还得看后面有没有人提 PR。仓库现在 12k star、1.1k fork、92 个 PR，热度是真的，第三方生产验证还没有。</p>
<h2>一个不刷榜的功能</h2>
<p>引擎里有两个功能，跑分用不上，线上排障很要命：batch-invariant inference 和 deterministic sampling。</p>
<p>前者保证同一个请求放进不同 batch，结果一致（目前仅 NVIDIA）。后者保证固定种子和采样参数下，输出可复现。</p>
<p>做过线上服务的人知道这有多烦：用户投诉“同样的输入，你两次答得不一样”，你复现不出来，只能瞎猜。开了 batch-invariant，性能会掉一点，但至少能查。</p>
<p>一个只想刷榜的框架不会做这个。它做这个，说明它真被人半夜叫起来过。</p>
<h2>聪明调度的拐点</h2>
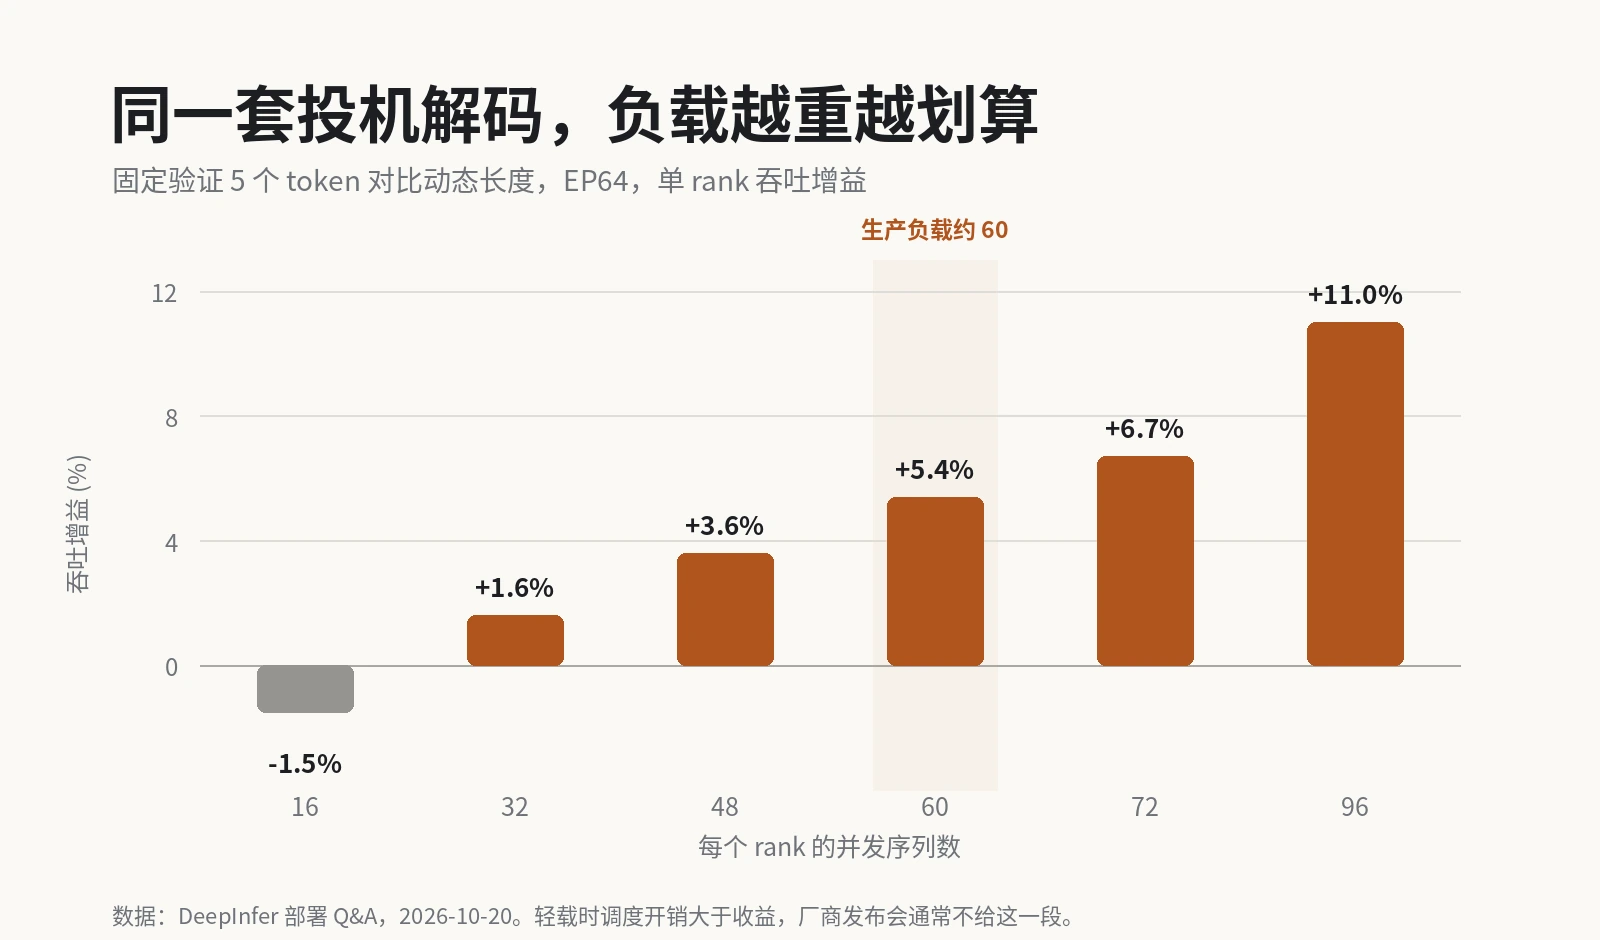
<p><img src="/images/posts/deepinfer/gain.webp" alt="动态验证长度的吞吐增益 w-100%" title="图 3：固定 5 个 token 与动态验证的吞吐对比。16 并发时是负收益，96 并发才有 11%。" /></p>
<p>DSpark 是引擎里的投机解码方案。一次猜 5 个 token，再用 confidence head 估计每个被接受的概率，把验证算力花在更可能通过的那些上。</p>
<p>听起来全是好处。Q&amp;A 给的表不太好看：</p>
<table>
<thead>
<tr>
<th>每 rank 并发</th>
<th>固定 5 个</th>
<th>动态长度</th>
<th>增益</th>
</tr>
</thead>
<tbody>
<tr>
<td>16</td>
<td>4891</td>
<td>4816</td>
<td>-1.5%</td>
</tr>
<tr>
<td>32</td>
<td>8964</td>
<td>9111</td>
<td>+1.6%</td>
</tr>
<tr>
<td>48</td>
<td>12032</td>
<td>12467</td>
<td>+3.6%</td>
</tr>
<tr>
<td>60</td>
<td>13730</td>
<td>14466</td>
<td>+5.4%</td>
</tr>
<tr>
<td>72</td>
<td>14962</td>
<td>15961</td>
<td>+6.7%</td>
</tr>
<tr>
<td>96</td>
<td>16817</td>
<td>18660</td>
<td>+11.0%</td>
</tr>
</tbody>
</table>
<p>轻载时是负收益。16 个并发，动态调度比固定长度慢 1.5%。生产负载 60 左右，增益 4% 到 7%。并发拉到 96，才有 11%。</p>
<p>这张表比任何“性能提升 XX%”的标题都有用。它告诉你拐点在哪，也告诉你什么时候别开这个开关。</p>
<p>厂商发布会只给你看峰值，Q&amp;A 才会把负收益写出来。这份 Q&amp;A 比代码值得读。</p>
<h2>谁该用，谁别碰</h2>
<p>有 128 张 SM100 或者 950 的云厂商、大厂推理团队：值得读，值得对着 Q&amp;A 调。这是目前最接近 DeepSeek 官方答案的东西。</p>
<p>想省 API 费的中小团队：别碰。你缺的不是引擎，是 KV Cache 集群、PD 分离、负载均衡，还有那 100 PiB 的 SSD。自己搭一圈，成本大概率高于买 API。</p>
<p>个人开发者：读完 README 就够了。知道生产级长什么样，比在自己那张卡上跑起来有用。</p>
<p>它不是 vLLM 的替代品。只支持一个模型，换模型要改内核，公开版还是离线推理。它更像“DeepSeek 模型的最优解说明书”，不是“通用推理框架”。</p>
<p>DeepSeek 在 README 里承认，这套东西最早基于 vLLM，也参考了 SGLang 和 TensorRT-LLM。美国公司写的框架，成了中国公司生产引擎的起点；中国公司把引擎开出来，又回到同一个池子。这个循环挺有意思。</p>
<h2>我的判断</h2>
<p>三句话。</p>
<p>第一，这次开源不会让 DeepSeek 的 API 收入掉多少。够得着 128 卡门槛的人，本来就会自己买卡；够不着的人，看完只会更清楚为什么该买 API。开源在这里更像营销费用，不是收入让渡。</p>
<p>第二，竞争重心已经从“模型有多强”挪到“每个 token 多少钱”。谁先把成本曲线公开，谁就定义了价格锚。155 万亿和 38 美元这两个数，会比很多 benchmark 活得久。</p>
<p>第三，对美国巨头来说，最难回答的不是“你们为什么不开源”，而是“如果推理栈不再是秘密，你们还剩下什么”。</p>
<p>答案可能是产品、分发、信任，也可能什么都不是。这个我不知道。</p>
<p>代码在 GitHub 上，Apache 2.0。真想验证，先看 <code>doc/inference_deployment_qa.md</code>，那份 Q&amp;A 比 README 实在。</p>
<h2>引用来源</h2>
<ol>
<li>DeepInfer 仓库（README、许可证、benchmark）：<a href="https://github.com/deepseek-ai/DeepInfer">https://github.com/deepseek-ai/DeepInfer</a></li>
<li>DeepSeek，《Inference Deployment Q&amp;A》（155 万亿、38 美元、128 卡、动态验证表格、缓存策略均出自此处）：<a href="https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md">https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md</a></li>
<li>deepseek-recipe 仓库（MIT 许可、协议转换范围）：<a href="https://github.com/deepseek-ai/deepseek-recipe">https://github.com/deepseek-ai/deepseek-recipe</a></li>
<li>量子位，《刚刚，DeepSeek 开源自家推理框架！》（2026-10-20，首字延迟、生成速度、缓存命中率）：<a href="https://m.sohu.com/a/1090300797_610300">https://m.sohu.com/a/1090300797_610300</a></li>
<li>36 氪，《DeepSeek：进一步将内部推理框架 DeepInfer 全面开源》（2026-10-20）：<a href="https://36kr.com/newsflashes/4033986510099335">https://36kr.com/newsflashes/4033986510099335</a></li>
<li>CellCog，《DeepSeek Open-Sources DeepInfer: What It Takes to Run》（未开源组件、100 PiB、EP8/EP64 对比）：<a href="https://cellcog.ai/blog/deepseek-deepinfer-open-source">https://cellcog.ai/blog/deepseek-deepinfer-open-source</a></li>
<li>MarkTechPost，《DeepSeek Open-Sources DeepInfer, the Inference Framework Behind DeepSeek-V4.1-Flash》（2026-10-20）：<a href="https://www.marktechpost.com/2026/10/20/deepseek-deepinfer-open-source-inference-framework">https://www.marktechpost.com/2026/10/20/deepseek-deepinfer-open-source-inference-framework</a></li>
<li>VentureBeat，《DeepSeek open sources DSpark, a new framework to speed up LLM inference by up to 85%》（2026-06）：<a href="https://venturebeat.com/ai/deepseek-open-sources-dspark-a-new-framework-to-speed-up-llm-inference-by-up-to-85">https://venturebeat.com/ai/deepseek-open-sources-dspark-a-new-framework-to-speed-up-llm-inference-by-up-to-85</a></li>
<li>openai/gpt-oss（Apache 2.0 开放权重）：<a href="https://github.com/openai/gpt-oss">https://github.com/openai/gpt-oss</a></li>
<li>google/JetStream（仓库公告：2026-02-01 归档，迁移至 tpu-inference）：<a href="https://github.com/AI-Hypercomputer/JetStream">https://github.com/AI-Hypercomputer/JetStream</a></li>
<li>vLLM：<a href="https://github.com/vllm-project/vllm">https://github.com/vllm-project/vllm</a></li>
<li>SGLang：<a href="https://github.com/sgl-project/sglang">https://github.com/sgl-project/sglang</a></li>
<li>NVIDIA TensorRT-LLM：<a href="https://github.com/NVIDIA/TensorRT-LLM">https://github.com/NVIDIA/TensorRT-LLM</a></li>
</ol>
<p>日期与数字取自上述来源。Q&amp;A 中的生产数据为厂商口径，本文未独立复测。</p>
]]></content>
    <author><name>林林</name></author>
    <category term="技术随笔"/>
  </entry>
  <entry>
    <title>魔搭白嫖 192G 显存：24G 和 192G 都跑了，全程让 AI 自己搭</title>
    <link href="https://www.lxii.cc/posts/modelscope-free-gpu-public-api/" rel="alternate" type="text/html"/>
    <id>https://www.lxii.cc/posts/modelscope-free-gpu-public-api/</id>
    <published>2026-10-17T23:20:00.000Z</published>
    <updated>2026-10-18T00:00:00.000Z</updated>
    <summary>魔搭的免费算力有三档：CPU、24G 的 A10、192G 的 AMD。今天开了台 192G 的，从装环境到接出公网全交给 AI，27B 全精度实测 52 token/s。</summary>
    <content type="html"><![CDATA[<h1>魔搭白嫖 192G 显存：24G 和 192G 都跑了，全程让 AI 自己搭</h1>
<p>今天刷魔搭的算力页面，看到免费额度那栏有三种环境：CPU、NVIDIA GPU、AMD GPU。CPU 是长期的，GPU 按小时给额度，其中 AMD 那档标着 192G 显存，100 小时。</p>
<p>24G 那档跑 27B 得量化，这件事我知道。192G 是什么概念，想亲手试一下。</p>
<p>于是开了台实例，把 SSH 丢给 AI，剩下的它自己来。</p>
<h2>三档免费算力</h2>
<table>
<thead>
<tr>
<th>环境</th>
<th>显存</th>
<th>免费额度</th>
<th>适合</th>
</tr>
</thead>
<tbody>
<tr>
<td>CPU</td>
<td>无</td>
<td>长期</td>
<td>数据处理、小模型、写代码</td>
</tr>
<tr>
<td>NVIDIA A10</td>
<td>24G（可用 23G）</td>
<td>100 小时</td>
<td>7B 到 14B 全精度，27B 必须量化</td>
</tr>
<tr>
<td>AMD MI308X</td>
<td>192G</td>
<td>100 小时</td>
<td>27B 全精度，还能再塞个生图模型</td>
</tr>
</tbody>
</table>
<p>24G 和 192G 差八倍，这不是「跑得快一点」的区别，是模型规模差一个档位。</p>
<p>一个 27B 的 dense 模型，BF16 权重 54GB。24G 装不下，只能压到 4bit 左右，13GB 能塞进去。192G 装得下原样的，还能剩下 130 多 G 给上下文。</p>
<p>上下文也是钱。256K 的 KV cache 按这个架构算下来大约 17GB，24G 那台根本开不到这个数，192G 那台可以满开。</p>
<p>还有一点：这些都不是「送一张卡」，是按小时计的体验额度。实例一停，上面装的东西就没了，只有 <code>/mnt/workspace</code> 挂的 NAS 还在。额度烧完就得等下一次。</p>
<h2>24G 那台：量化是唯一解</h2>
<p>Qwen3.8-27B，BF16 权重 54GB，A10 只有 23G 可用。量化到 Q3_K_XL，13GB，再带一个 889MB 的视觉模块。</p>
<p>llama.cpp 编译时开 CUDA，A10 是 Ampere，arch 86。</p>
<pre><code>llama-server \
  -m models/Qwen3.8-27B-Unleashed-UD-Q3_K_XL.gguf \
  --mmproj models/mmproj-model-bf16.gguf \
  --host 127.0.0.1 --port 8081 \
  -ngl 999 -c 262144 -np 1 \
  --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --alias qwen3.8-27b
</code></pre>
<p><code>-ngl 999</code> 是把所有层都放到 GPU 上，不够就分层，剩下的回 CPU，速度会掉一个数量级。</p>
<p><code>-c 262144</code> 是上限，实际开多大看显存。13GB 权重压着，KV cache 再一挤，256K 跑不满。这个数别照抄，按剩余显存调。</p>
<p><code>--cache-type-k q5_1</code> 是把 KV cache 也量化，省显存，代价是长上下文里精度掉一点。</p>
<p>实测生成 16 token/s，prompt 处理 378 token/s。写代码能用，跑 agent 也能跑，秒回是别想。一次长回答要等几十秒，思考链一长更明显。</p>
<h2>192G 那台</h2>
<p>硬件是 MI308X，ROCm 7.2.3，单卡显存 205822885888 字节，191.7 GiB。23 vCPU，200 GiB 内存，无 swap。Ubuntu 22.04.5，内核 5.10.134。<code>/mnt/workspace</code> 挂在 NFS 上，池子 1 PB，剩 972 TB；<code>/tmp</code> 是本地盘，30 GB。</p>
<p>有两个地方容易误判。</p>
<p><code>amd-smi</code> 只列 GPU 0，容器里 <code>torch.cuda.device_count()</code> 返回 1。PCI 上能看到多张卡，实际只给一张切片。所以 <code>--tensor-parallel-size 8</code> 这种想法可以直接放弃，单卡跑。</p>
<p><code>/mnt/workspace</code> 是 NFS。编译放 <code>/tmp</code>，源码可以留 NFS。在 NFS 上编译又慢又容易踩文件锁。</p>
<p>模型选的是 Qwen3.8-27B-abliterated，BF16，55.56GB，18 个 shard。魔搭上没有这个模型，HF 直连超时，走 <code>hf-mirror.com</code> 拉到 <code>/mnt/workspace/models/Qwen3.8-27B-abliterated</code>。</p>
<p>本来想沿用 llama.cpp，省事。走不通，两条路都堵。</p>
<p><code>convert_hf_to_gguf.py</code> 没注册 <code>qwen3_5</code> 架构，转换脚本不认这个模型。仓库里现成的 <code>llama-cli</code> 是 CUDA 编的，<code>libggml-cuda.so</code> 在 ROCm 机器上加载就报错。要重编，得加 <code>-DGGML_HIP=ON -DAMDGPU_TARGETS=gfx942</code>。</p>
<p>那就换 vLLM。0.28.0，torch 2.12.0（hip 7.2.53211）。模型注册表里 <code>Qwen3_5ForConditionalGeneration</code> 是认识的。</p>
<pre><code>vllm serve /mnt/workspace/models/Qwen3.8-27B-abliterated \
  --served-model-name qwen3.8-27b-abliterated \
  --max-model-len 262144 \
  --gpu-memory-utilization 0.92 \
  --reasoning-parser qwen3 \
  --enable-prefix-caching \
  --async-scheduling
</code></pre>
<p><code>--max-model-len 262144</code> 是模型支持的最大上下文，直接拉满。显存够就不用缩。</p>
<p><code>--gpu-memory-utilization 0.92</code> 是允许 vLLM 占用 92% 的显存，剩下的留给系统和其他进程。这台机器只有模型在跑，可以给高一点。</p>
<p><code>--reasoning-parser qwen3</code> 是让 vLLM 认识这个模型的思考格式，把思考内容和正文分开。不加的话，思考链会混在正文里返回。</p>
<p><code>--enable-prefix-caching</code> 是前缀缓存。同一段 system prompt 反复用的时候，不用每次重算，首字延迟会低很多。</p>
<p><code>--async-scheduling</code> 是异步调度，并发请求下吞吐会好一些。</p>
<p>单卡加载 51.1 GiB，262144 上下文没炸。显存账：权重 55.56G，256K KV 大约 17G，合计 73G，占 192G 的 38%。余量很大，这台机器再跑一个模型都行。</p>
<p>速度：TTFT 0.06 秒，decode 52 到 54 token/s，思考模式关掉，端到端快 24%。</p>
<p>TTFT 0.06 秒这个数有点夸张，是因为 prefix caching 生效了，同一段系统提示词不用重算。冷启动第一次请求会慢一些。</p>
<p>两边对比：</p>
<table>
<thead>
<tr>
<th></th>
<th>A10 24G</th>
<th>MI308X 192G</th>
</tr>
</thead>
<tbody>
<tr>
<td>权重</td>
<td>Q3_K_XL 13GB</td>
<td>BF16 55.56GB</td>
</tr>
<tr>
<td>框架</td>
<td>llama.cpp</td>
<td>vLLM</td>
</tr>
<tr>
<td>生成</td>
<td>16 tok/s</td>
<td>52-54 tok/s</td>
</tr>
<tr>
<td>prompt</td>
<td>378 tok/s</td>
<td>TTFT 0.06s</td>
</tr>
<tr>
<td>上下文</td>
<td>256K 开不满</td>
<td>262144 满开</td>
</tr>
<tr>
<td>显存占用</td>
<td>接近打满</td>
<td>73G / 192G</td>
</tr>
</tbody>
</table>
<p>两个框架不一样，速度差不能全算在显存头上。llama.cpp 的 GGUF 推理和 vLLM 的 PagedAttention 本来就是两种设计。</p>
<p>但 24G 那台就算换成 vLLM，13GB 的量化权重也装不出全精度的效果。量化损失在长上下文和复杂推理里会放大，尤其是代码和数学。</p>
<h2>中间层</h2>
<p>vLLM 的接口是 OpenAI 兼容的，但「兼容」不等于「一样」。客户端和上游之间有三处不一致，需要在中间加一层代理处理。</p>
<p>字段名。vLLM 把思考内容放在 <code>reasoning</code>，很多客户端读的是 <code>reasoning_content</code>。这是两套约定，不是谁写错了。代理里做一次字段重命名，流式和非流式都要处理。</p>
<p>思考 token 算进预算。<code>max_tokens</code> 给小的时候，思考把预算吃完，正文一个字没有，返回的 <code>content</code> 是 null。客户端不报错，就是空回复。处理方式有两种：给足预算，或者在代理里把思考内容分离出去，不占正文的额度。</p>
<p>流式分块的结构。SSE 每一块都要是合法的 JSON，思考内容和正文可能在同一块里交替出现。代理要按块解析，改完再拼回去，不能整段读完了再一次性发。</p>
<p>这一层不复杂，但必须有。没有它，客户端要么连不上，要么拿到空回复，要么流式断在半路。</p>
<h2>顺手把生图接上</h2>
<p>192G 空着也是空着。</p>
<p>选的是 Qwen-Image 2.1 Turbo 的 abliterated 版，8 步出图。三个文件：</p>
<table>
<thead>
<tr>
<th>文件</th>
<th>大小</th>
</tr>
</thead>
<tbody>
<tr>
<td>扩散模型 Q5_K_M</td>
<td>4.94 GB</td>
</tr>
<tr>
<td>Text Encoder 4bit</td>
<td>5.03 GB</td>
</tr>
<tr>
<td>VAE bf16</td>
<td>675 MB</td>
</tr>
</tbody>
</table>
<p>先试的 ComfyUI。Radeon 上 1024x1024 一步超过五分钟，不可用。换 stable-diffusion.cpp，源码编 HIP 版：</p>
<pre><code>cmake -B build -DGGML_HIP=ON -DAMDGPU_TARGETS=gfx942
</code></pre>
<p>产物 <code>sd-cli</code>，直接命令行出图：</p>
<pre><code>sd-cli --diffusion-model models/qwen-image/Q5_K_M.gguf \
  --llm models/qwen-image/TE-4bit.gguf \
  --vae models/qwen-image/vae.safetensors \
  --steps 8 --cfg-scale 1.0 --sampling-method euler \
  --diffusion-fa --vae-tiling \
  -W 1024 -H 1024 -p "prompt" -o out.png
</code></pre>
<p><code>--steps 8</code> 是这个 Turbo 版本的特点，普通扩散模型要 20 到 30 步。<code>--cfg-scale 1.0</code> 是蒸馏模型的标准值，不需要 classifier-free guidance 的放大。<code>--diffusion-fa</code> 开 flash attention，<code>--vae-tiling</code> 把 VAE 解码分块做，省显存。</p>
<p>1024x1024 八步的耗时分解：每步 1.62 秒，采样总计 23.75 秒，VAE 解码 7.78 秒，冷启动 43.5 秒。</p>
<p>和 27B 的 vLLM 同时开着，不 OOM。两个模型加起来占用不到 80G。</p>
<p>命令行不好用，包了一层 FastAPI，暴露 <code>/v1/images/generations</code>，返回 b64。端口选 8083，因为 8082 被 code-server 占了。开服务之前先 <code>ss -ltn</code> 看一眼，别硬撞。</p>
<h2>把服务接出来</h2>
<p>实例没有公网 IP，也不给开入站。只能让实例主动连出来，在自己的服务器上开监听。</p>
<pre><code>ssh -N -p 14413 -i ~/.ssh/dsw_key \
  -R 172.21.0.1:16384:127.0.0.1:2222 \
  -R 172.21.0.1:16385:127.0.0.1:8000 \
  root@tunnel.example.com
</code></pre>
<p>16384 转发到实例的 22，16385 转发到模型端口。从服务器上看，模型就像跑在本地。</p>
<p>绑定地址写 <code>127.0.0.1</code> 只有服务器本机能连，容器里的网关连不上，得写网关 IP。这个地址在实例里看到的是 <code>172.21.0.1</code>。</p>
<p>加第三个端口给生图的时候，一直报 <code>remote port forwarding failed for listen port 16386</code>。</p>
<p>服务器上 <code>ss -ltn</code> 看，端口空着。<code>sshd_config</code> 里 <code>GatewayPorts clientspecified</code>，<code>permitlisten</code> 是 any。改了配置、reload 了 sshd，还是不行。</p>
<p>日志里有一行关键：</p>
<pre><code>Received request from x.x.x.x port xxxxx to remote forward to host 172.21.0.1 port 16386, but the request was denied.
</code></pre>
<p>denied，不是 bind 失败。开 <code>LogLevel DEBUG1</code>：</p>
<pre><code>debug1: active: permitted listen: 172.21.0.1:16384
debug1: active: permitted listen: 172.21.0.1:16385
</code></pre>
<p>原因在 <code>authorized_keys</code>。当初为了安全，那把 key 前面挂了 <code>restrict,port-forwarding,permitlisten="172.21.0.1:16384",permitlisten="172.21.0.1:16385"</code>，白名单只有两个端口。新端口不在名单里，sshd 直接拒。</p>
<p>补一条 <code>permitlisten="172.21.0.1:16386"</code>，立刻通。</p>
<p>这是安全配置的副作用：白名单越严，加新端口越容易忘。报错只到 denied，不会说哪条规则拒的。<code>LogLevel DEBUG1</code> 一行就能定位，比翻配置快。</p>
<h2>客户端怎么用</h2>
<p>任何 OpenAI 兼容的客户端都行，Base URL 填服务器上隧道的地址：</p>
<pre><code>http://172.21.0.1:16385
</code></pre>
<p>密钥填模型启动时的 <code>--api-key</code>，模型名填 <code>--served-model-name</code> 的值。</p>
<p>Base URL 不要带 <code>/v1</code>，客户端自己会拼。带了就是 404，很容易顺手加上。</p>
<p>生图走 <code>http://172.21.0.1:16386/v1/images/generations</code>，参数是 <code>prompt</code>、<code>size</code>（WxH）、<code>n</code>（最多 4）、<code>negative_prompt</code>、<code>seed</code>、<code>steps</code>。</p>
<p>实测：512x512 直连 7 秒，1024x1024 约 25 秒。请求是串行的，同时发会排队。</p>
<h2>值不值</h2>
<p>免费 192G 是真的，但不是免费 API。</p>
<p>额度按小时烧，实例会停，重开一台 IP 和端口全变，脚本得重跑。适合试模型、跑一次性任务、给 agent 当备用后端。不适合长期在线、对外服务、对延迟敏感。</p>
<p>还有，别把 <code>0.0.0.0</code> 开到公网。全程监听 <code>127.0.0.1</code>，出口走 SSH，入口是带 restrict 的 key。免费算力是别人的，机器上的东西泄了，麻烦是自己的。</p>
<p>真正的变化不是显存，是门槛。</p>
<p>以前要查文档、试环境、踩驱动坑，一个模型折腾一天。现在把 SSH 丢给 AI，探环境、下模型、选框架、配参数、排协议差异，它自己一条条过。我只开了个实例，回了两句话。</p>
<p>免费算力是别人的，时间和试错才是自己的。</p>
]]></content>
    <author><name>林林</name></author>
    <category term="技术随笔"/>
  </entry>
  <entry>
    <title>难绷！大肥鱼更新完变沉默了，只框框干活不说话</title>
    <link href="https://www.lxii.cc/posts/deepseek-v4-1-flash-1017/" rel="alternate" type="text/html"/>
    <id>https://www.lxii.cc/posts/deepseek-v4-1-flash-1017/</id>
    <published>2026-10-17T12:10:00.000Z</published>
    <updated>2026-10-17T12:10:00.000Z</updated>
    <summary>10 月 17 日，DeepSeek V4.1 Flash 更新到 1017。分数全面上涨，输出更短、任务更快，价格没变；搜索 API 也一起开放了。</summary>
    <content type="html"><![CDATA[<h1>难绷！大肥鱼更新完变沉默了，只框框干活不说话</h1>
<p>10 月 17 日，DeepSeek 把 V4.1 Flash 更新到了 V4.1-Flash-1017。网页、App、API 同步换新，模型名还是 <code>deepseek-flash</code>，调用代码不用改。</p>
<p>分数涨了，话变少了，钱没多花。</p>
<h2>分数</h2>
<p>官方给了一张对比表，1017 对上一版 V4.1 Flash：</p>
<table>
<thead>
<tr>
<th>基准测试</th>
<th>1017</th>
<th>上一版</th>
<th>变化</th>
</tr>
</thead>
<tbody>
<tr>
<td>HLE（无工具）</td>
<td>42.6</td>
<td>36.8</td>
<td>+5.8</td>
</tr>
<tr>
<td>Terminal-Bench 4.0</td>
<td>42.3</td>
<td>31.2</td>
<td>+11.1</td>
</tr>
<tr>
<td>DeepSWE v1.1</td>
<td>77.0</td>
<td>74.2</td>
<td>+2.8</td>
</tr>
<tr>
<td>ProgramBench</td>
<td>29.1</td>
<td>20.3</td>
<td>+8.8</td>
</tr>
<tr>
<td>NL2Repo-Bench</td>
<td>68.2</td>
<td>65.4</td>
<td>+2.8</td>
</tr>
<tr>
<td>Automation-Bench v1.0.6</td>
<td>60.5</td>
<td>54.8</td>
<td>+5.7</td>
</tr>
<tr>
<td>Agents' Last Exam</td>
<td>35.4</td>
<td>31.8</td>
<td>+3.6</td>
</tr>
<tr>
<td>Apex Bench v1.1</td>
<td>72.1</td>
<td>64.6</td>
<td>+7.5</td>
</tr>
</tbody>
</table>
<p>Terminal-Bench 4.0 从 31.2 跳到 42.3，是最大的一跳。这项考的是在终端里真干活：读文件、跑命令、改环境、把任务收尾。天天用 agent 写代码的人，看这项比看 HLE 有用。</p>
<p>DeepSWE v1.1 是 77.0。同一张表里，Opus 5 是 74.0，GPT-5.6 Sol 是 73.0。这些数字是厂商自己跑的，不是第三方复测，看趋势可以，别当成你手上项目的保证。</p>
<p>Terminal-Bench 用 Claude Code 跑，DeepSWE 用 mini-SWE-v2 跑。</p>
<h2>钱花在哪</h2>
<p>Agent 任务的钱，很大一部分花在模型来回说话上。每一步多写两百字，几十步下来就是一笔账。官方说 1017 在涨分的同时，把任务运行时间和输出长度都压了下来，所以在多个 Harness 下做到了更低的单任务成本。</p>
<p>底子还是 9 月那套：552B 参数的 MoE，非对称的 Causal-Encoder-Decoder，输入激活 8B，输出激活 16B。KV Cache 比上一代省，HBM 占用降到四分之一，SSD 降到八分之一。</p>
<p>价格没涨：</p>
<table>
<thead>
<tr>
<th>每百万 token</th>
<th>闲时</th>
<th>高峰</th>
</tr>
</thead>
<tbody>
<tr>
<td>输入（缓存命中）</td>
<td>$0.003</td>
<td>$0.006</td>
</tr>
<tr>
<td>输入（缓存未命中）</td>
<td>$0.15</td>
<td>$0.30</td>
</tr>
<tr>
<td>输出</td>
<td>$0.60</td>
<td>$1.20</td>
</tr>
</tbody>
</table>
<p>高峰是北京时间周一到周五的 09:00–12:00、14:00–18:00，法定节假日不算。其余时间按闲时价，正好一半。</p>
<p>上下文窗口 1M，最大输出 384K。窗口大是好事，但不控制输入的话，一次请求带几十万 token 也是它。便宜的前提是别把整个仓库无脑塞进去。</p>
<h2>四个从零开始的例子</h2>
<p>这次主打的演示不是补代码，是直接交项目：故宫的 3D 建模、一个网页版赛车游戏、用 Godot 复刻的《传送门 2》，还有「Valley of Ages」，用 3D 场景从史前演到现代。</p>
<p>训练方法是带自反馈的强化学习。模型做完一步，自己检查结果，再决定下一步怎么改。官方说这让它在提示词少、素材少、交互轮次短的情况下，能直接把完整项目做出来。</p>
<p>演示是挑过的，别拿它当交付标准。但它说明了一件事：模型厂商现在比的不是谁更会聊天，是谁能一次把活干完。</p>
<h2>搜索 API</h2>
<p>DeepSeek 把自研搜索开放成了两个接口：Search 和 Fetch，各 5 元 / 千次（美元价 $0.75 / 千次）。</p>
<p>官方说索引了全球千亿级网页，支持多语言，专门过滤三类东西：SEO 作弊、GEO 操纵、低质 AIGC。对做内容的人来说这是好事，被搜到的门槛回到了「写给人看」。</p>
<p>有个时间点要记：在 DeepSeek Harness、Claude Code、Codex 里通过服务端工具调用 Search/Fetch，北京时间 11 月 1 日 00:00 前不收费，之后按次计费。</p>
<h2>接入</h2>
<p>用 DeepSeek Harness 的，升到 0.2.1-rc.1 或更高，否则拿不到新模型的最佳效果。</p>
<p>调用名没变，还是 <code>deepseek-flash</code>。旧的 <code>deepseek-v4-flash</code> 和 <code>deepseek-v4-flash-vision-exp</code> 也还能用，但请求会被转到 1017，按 Flash 价计费。</p>
<p>模型权重同步开源，Hugging Face 和 ModelScope 都能下，MIT 许可。</p>
<h2>值不值得换</h2>
<p>做 agent 开发的，值得。Terminal-Bench 和 DeepSWE 涨得实在，输出变短会直接反映在账单上。原来嫌它话多的，可以再试一次。</p>
<p>只拿它聊天的，感知不会太强。分数主要涨在工具调用和长任务上，日常问答没那么明显。</p>
<p>上下文成本还是要注意。1M 窗口不是让你每次都塞满。该裁的历史、该丢的文件、该分段的活，还是得做。</p>
<p>这次更新最值钱的地方不是榜单，是同样的任务花更少的钱和时间。模型竞争打到这个阶段，便宜已经不算优势了，又便宜又能把活干完才算。</p>
<p>Qoder 和 WorkBuddy 也已经全量接入 1017，不用自己折腾接入。</p>
<h2>引用来源</h2>
<ol>
<li>DeepSeek-V4.1-Flash-1017 发布公告：https://api-docs.deepseek.com/zh-cn/news/news261017</li>
<li>模型与价格：https://api-docs.deepseek.com/zh-cn/quick_start/pricing</li>
<li>模型卡（基准测试、MIT 许可）：https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017</li>
<li>DeepSeek-V4.1-Flash 发布公告（552B MoE、8B/16B 激活、KV Cache）：https://api-docs.deepseek.com/zh-cn/news/news260910</li>
<li>Qoder 接入文档：https://api-docs.deepseek.com/zh-cn/quick_start/agent_integrations/qoder</li>
<li>WorkBuddy/CodeBuddy 接入文档：https://api-docs.deepseek.com/zh-cn/quick_start/agent_integrations/workbuddy</li>
<li>Search &amp; Fetch 指南：https://api-docs.deepseek.com/zh-cn/guides/search</li>
</ol>
]]></content>
    <author><name>林林</name></author>
    <category term="技术随笔"/>
  </entry>
  <entry>
    <title>大模型要进出口管制目录了，开源还开得了吗？</title>
    <link href="https://www.lxii.cc/posts/ai-export-control-catalog-2026/" rel="alternate" type="text/html"/>
    <id>https://www.lxii.cc/posts/ai-export-control-catalog-2026/</id>
    <published>2026-10-17T03:00:00.000Z</published>
    <updated>2026-10-17T03:00:00.000Z</updated>
    <summary>一张截图在传，说以后大模型不让开源了。把官方附件原文翻出来对一遍，结论是反的：开源没被禁。</summary>
    <content type="html"><![CDATA[<h1>大模型要进出口管制目录了，开源还开得了吗？</h1>
<p>开源没被禁。</p>
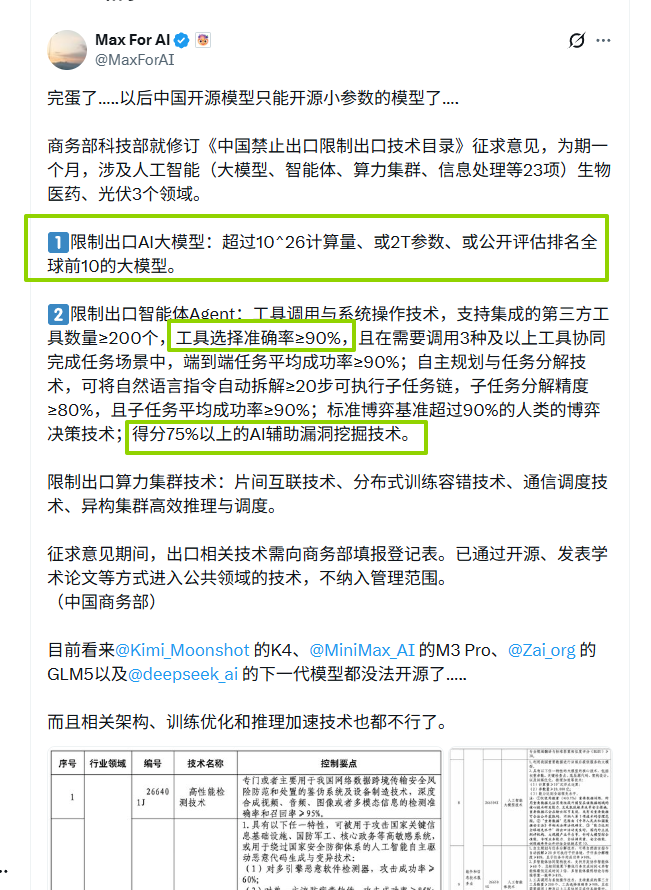
<p>这两天有张截图在传，说以后大模型不让开源了。截图里的数字大多对得上，结论读反了。</p>
<p>10 月 16 日，商务部和科技部发了份征求意见稿，准备往《中国禁止出口限制出口技术目录》里加东西。这份目录管的是哪些技术不能卖到国外、哪些得先申请批准。</p>
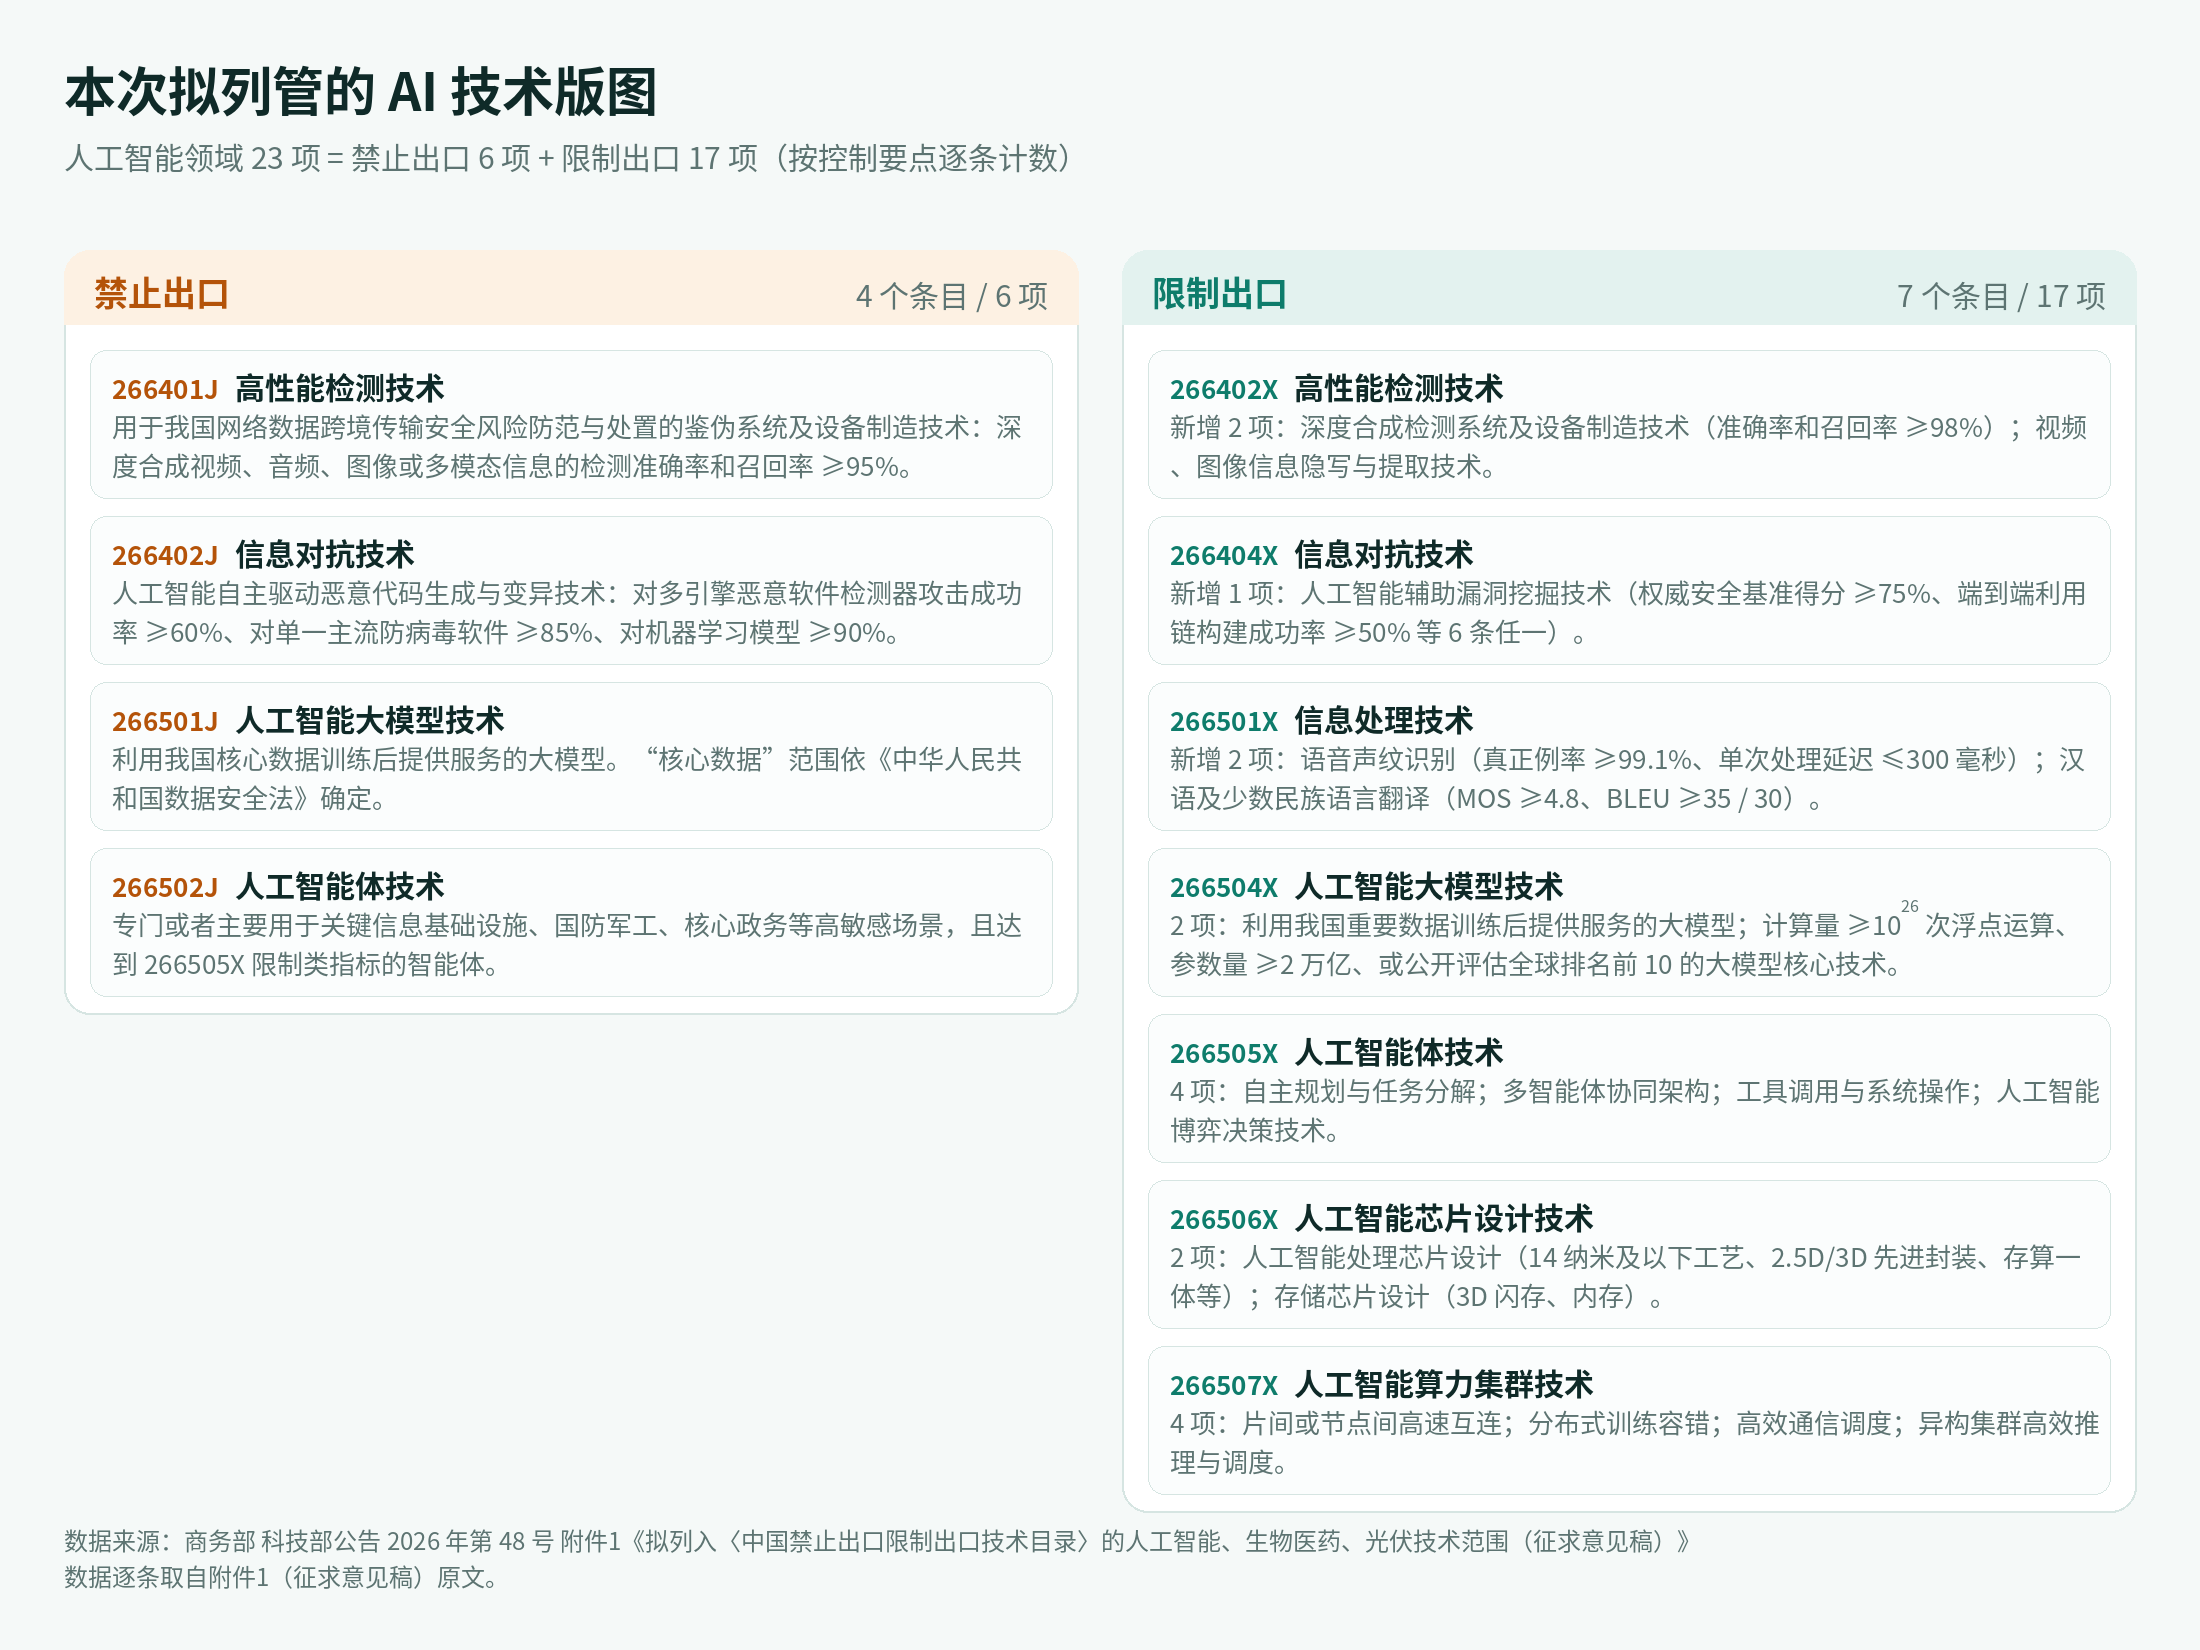
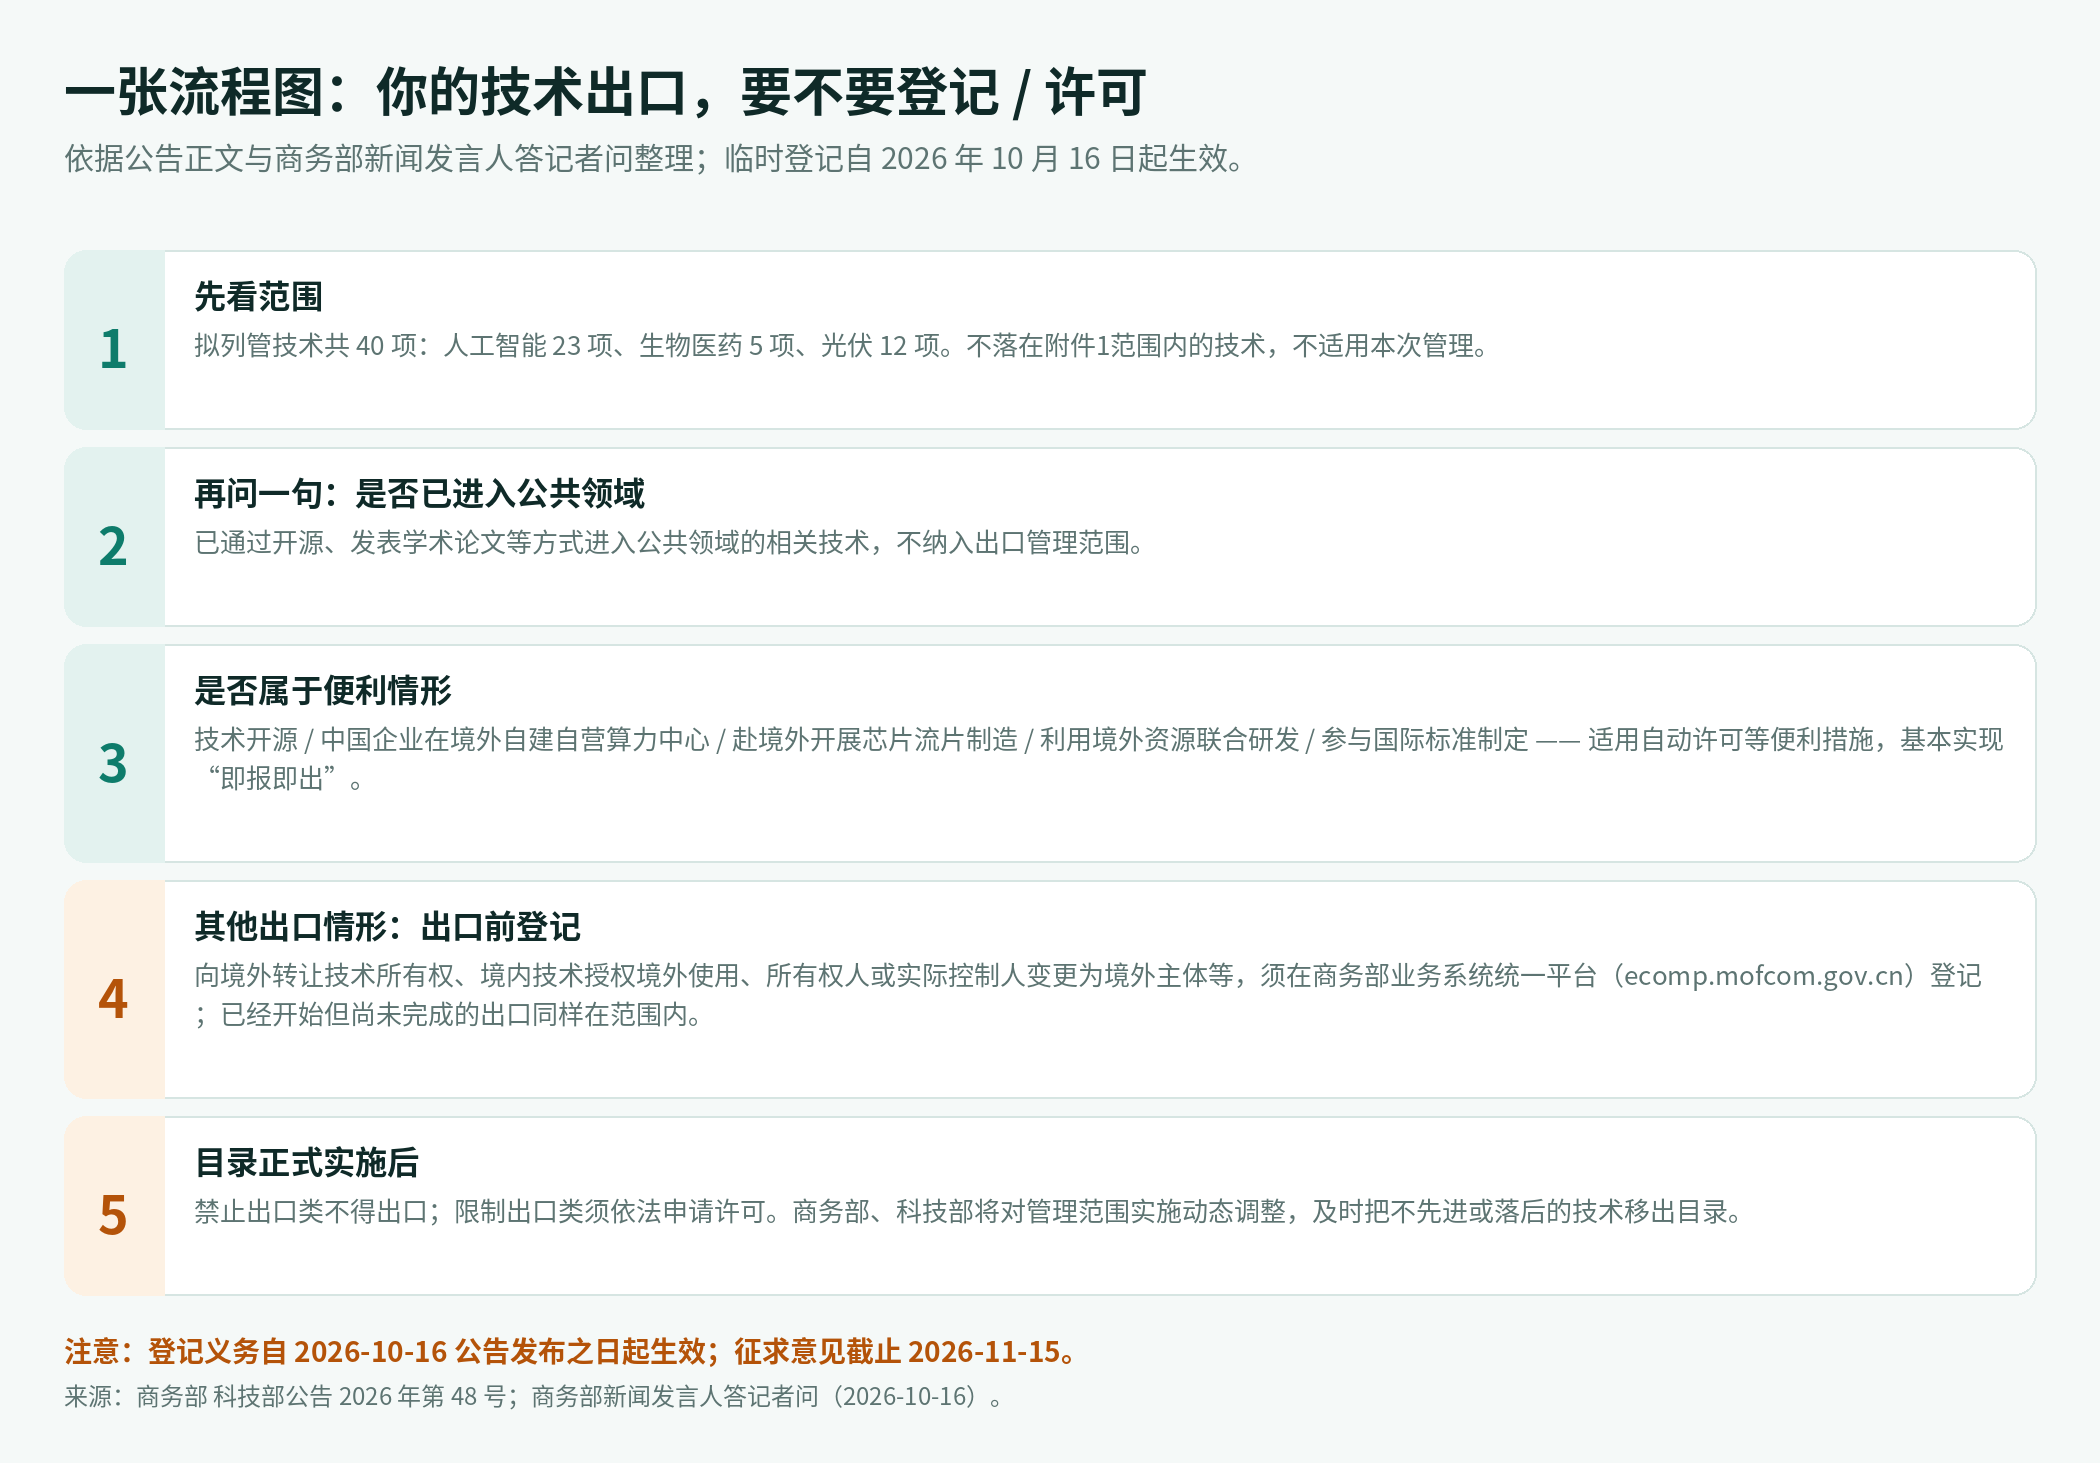
<p>这次一共加 40 项：人工智能 23 项、生物医药 5 项、光伏 12 项。征求意见到 11 月 15 日截止。但有一条已经生效了——从现在起，相关技术出口前要先做临时登记。稿子还没定，手续先走起来了。</p>
<p>具体指标不写在公告正文里，全在附件那个 <code>.wps</code> 文件里。下面的数字都是从附件原文逐条对的。</p>
<p><img src="/images/posts/ai-export-control/map.webp" alt="人工智能 23 项技术拆解 w-100%" title="图 1：人工智能 23 项技术拆解。数据逐条取自附件1（征求意见稿）原文。" /></p>
<p>管的是技术，不是产品。附件里写得很直白：用这些技术造出来的产品，不在管理范围内。</p>
<p>人工智能这 23 项分两类，禁止出口和限制出口，后者松一些。禁止出口那部分里，跟模型有关的一条是：用我国核心数据训练、然后对外提供服务的大模型。</p>
<p>对做模型的人来说，真正要看的是三条线。踩中任意一条就在范围内：</p>
<ul>
<li>训练算力 ≥ 10²⁶ 次浮点运算</li>
<li>参数量 ≥ 2 万亿</li>
<li>公开评测全球排名前 10</li>
</ul>
<p>管的内容包括模型权重、关键检查点、底层源代码、架构设计，以及训练优化、推理加速的技术。另外还有智能体、算力集群、芯片设计几条线，门槛更细，离普通人远，图 1 里都有。</p>
<p>开源还能不能？能。</p>
<p>已经开源、论文已经发了的，不归它管。进了公共领域的技术，不纳入出口管理。现在要开源的，属于便利情形，走自动许可，基本报一下就能出。把技术授权给别人，或者公司实控人变成境外主体，这个要登记；目录正式落地后还要申请许可。</p>
<p>答记者问里，跟开源并列的便利情形还有一串：去境外自建算力中心、去境外做芯片流片、跟境外联合研发、参与国际标准制定。把技术交出去，和自己出去做，是两码事，后者走便利。</p>
<p><img src="/images/posts/ai-export-control/flow.webp" alt="出口合规流程 w-100%" title="图 2：从范围到许可的判断顺序。依据公告正文与答记者问整理。" /></p>
<p>三条线里，前两条企业自己心里有数，第三条只能猜。</p>
<p>附件的定义是「出口活动发生时，国内外主流测评机构、大规模产业平台等公开评估全球排名前 10」。哪个榜单算数、谁说了算，没写。</p>
<p>这是征求意见期最值得提的一条。</p>
<p><img src="/images/posts/ai-export-control/source-tweet.webp" alt="网传的那条帖子 w-45%" title="图 3：网传引发讨论的那条帖子（出处见文末引用）。数字大多对得上，结论偏了。" /></p>
<h2>引用来源</h2>
<ol>
<li>商务部 科技部公告 2026 年第 48 号（正文与附件下载入口）：<a href="https://www.mofcom.gov.cn/zwgk/zcfb/art/2026/art_0a31a3c9ac404f7a9b0e917ce3412997.html">https://www.mofcom.gov.cn/zwgk/zcfb/art/2026/art_0a31a3c9ac404f7a9b0e917ce3412997.html</a></li>
<li>附件1《拟列入〈中国禁止出口限制出口技术目录〉的人工智能、生物医药、光伏技术范围（征求意见稿）》——本文指标数字均出自该文件原文（<code>.wps</code>，下载入口在上一条公告页内）</li>
<li>商务部新闻发言人答记者问：<a href="https://www.mofcom.gov.cn/syxwfb/art/2026/art_a4acff07e134447fbe7bbeb486df3ea6.html">https://www.mofcom.gov.cn/syxwfb/art/2026/art_a4acff07e134447fbe7bbeb486df3ea6.html</a></li>
<li>新华社通稿：<a href="https://www.news.cn/20261016/1a2537e95a6148c896e4c7543f48ceb3/c.html">https://www.news.cn/20261016/1a2537e95a6148c896e4c7543f48ceb3/c.html</a></li>
<li>登记平台：<a href="https://ecomp.mofcom.gov.cn">https://ecomp.mofcom.gov.cn</a></li>
<li>截图原始出处：<a href="https://x.com/MaxForAI/status/2111089608020664680">https://x.com/MaxForAI/status/2111089608020664680</a></li>
</ol>
<p>附件还在征求意见阶段，最终以正式发布的目录为准。提意见的邮箱是 <code>jinxianmulu@mofcom.gov.cn</code>，截止 11 月 15 日。</p>
]]></content>
    <author><name>林林</name></author>
    <category term="技术随笔"/>
  </entry>
  <entry>
    <title>Gemini 把新旗舰锁进订阅了，免费用户还剩什么？</title>
    <link href="https://www.lxii.cc/posts/gemini-news-2026-10/" rel="alternate" type="text/html"/>
    <id>https://www.lxii.cc/posts/gemini-news-2026-10/</id>
    <published>2026-10-13T02:00:00.000Z</published>
    <updated>2026-10-13T02:00:00.000Z</updated>
    <summary>10 月 13 日新旗舰 Argon 进 Gemini 应用，只给 AI Pro 和 Ultra；10 月 9 日起免费个人账号只剩 Flash-Lite。11 月 2 日，免费档在 Antigravity 里还要再丢两个模型。</summary>
    <content type="html"><![CDATA[<h1>Gemini 把新旗舰锁进订阅了，免费用户还剩什么？</h1>
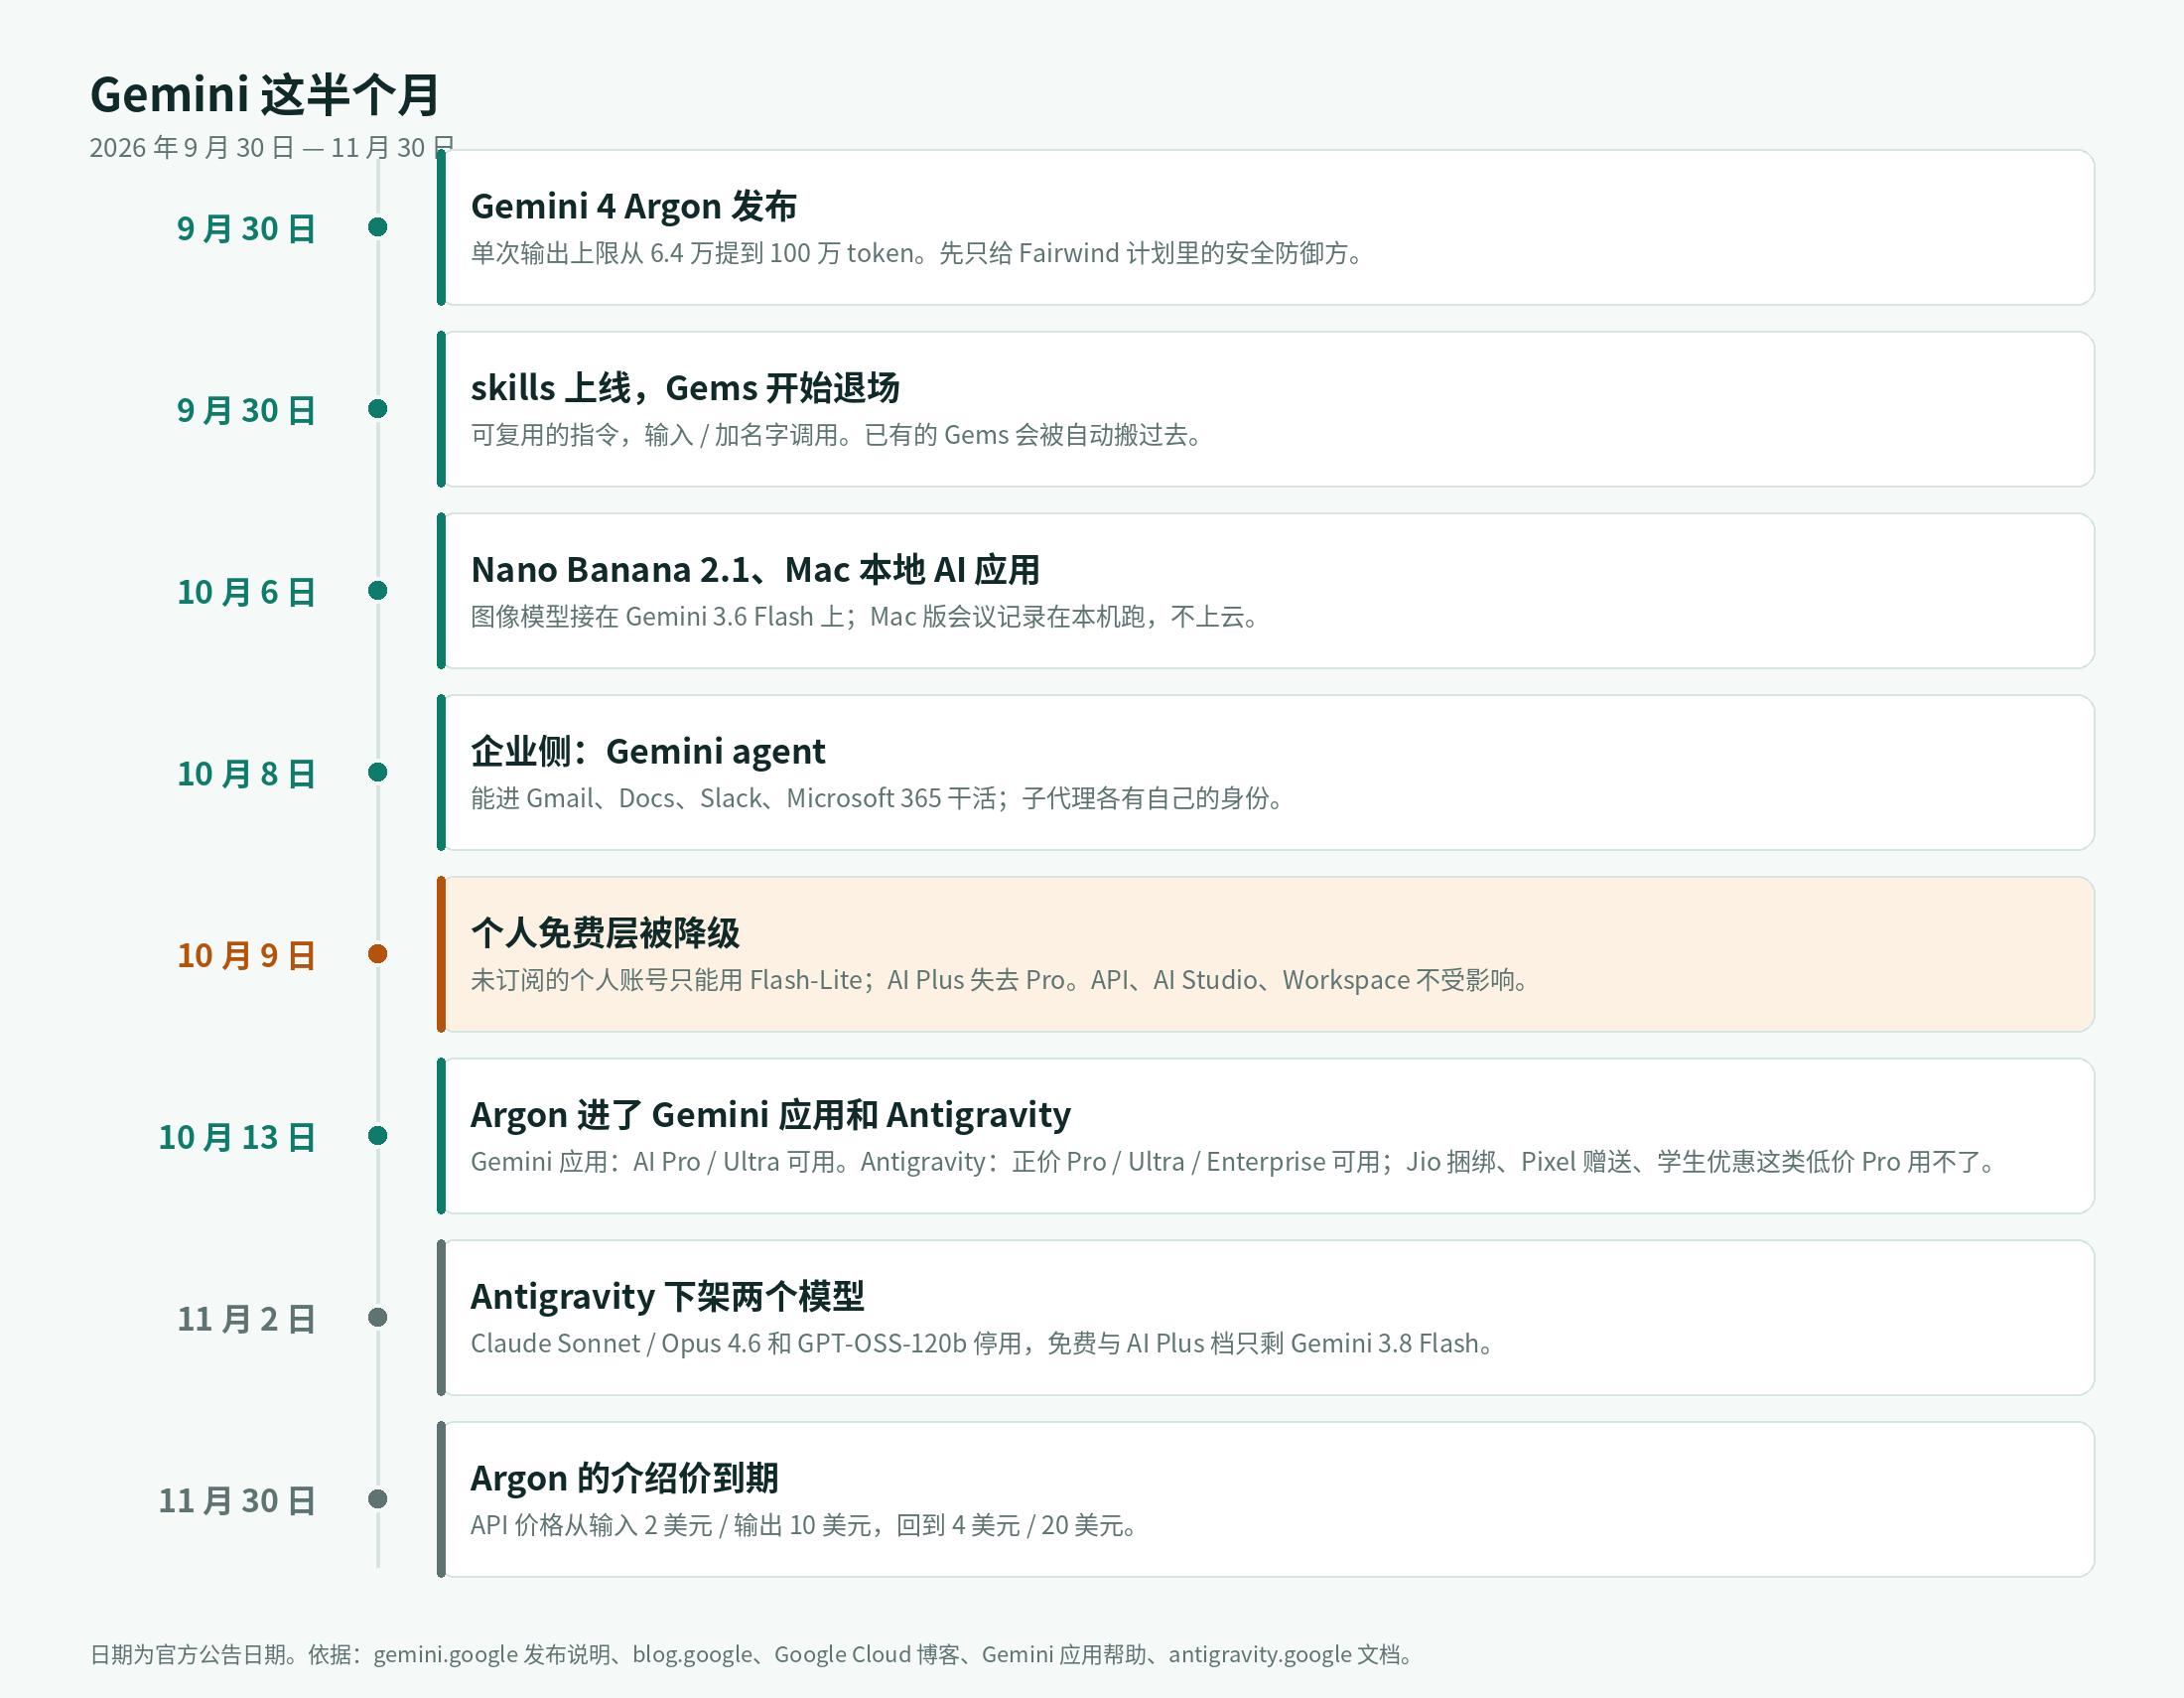
<p>10 月 13 日，Gemini 4 Argon 进了 Gemini 应用，只对 AI Pro 和 Ultra 开放。免费用户和 AI Plus 用户看不到这个选项。</p>
<p>这是第三刀。10 月 9 日已经砍过一刀，没订阅的个人账号只剩 Flash-Lite；11 月 2 日还有一刀，Antigravity 里免费档能用的两个非 Google 模型也要下架。</p>
<p>Gemini 正在从「一个模型给所有人」变成「按订阅分档」。</p>
<p><img src="/images/posts/gemini-news/timeline.webp" alt="Gemini 这半个月的时间线 w-100%" title="图：2026 年 9 月 30 日到 11 月 30 日，Gemini 的主要变化。日期均为官方公告日期。" /></p>
<h2>Argon 值不值得在意</h2>
<p>9 月 30 日，Google 发布 Gemini 4 Argon。最显眼的数字是单次输出上限从 6.4 万 token 提到 100 万 token。以前模型写长东西容易断在半路，这一档就是冲长任务去的：跨文件重构、长文档分析、多步骤自动化。</p>
<p>按 Google 自己公布的数据，它在几个榜上位置不错：Vals Index 第一，Artificial Analysis 智能指数（high 档）53 分，和 GPT-6 Astra、Claude Fable 5.1 打平，比 Claude Opus 5.5 的 58 分低 5 分。这些都是厂商自己公布或第三方机构实测的数字，不是实际体验保证。榜单强不代表你手上的活干得好，反过来也一样。</p>
<p>发布当天它不对外开放，只给 Fairwind 计划里的安全防御团队用。Google 的说法是这一档能力要先收着放，边用边调护栏。</p>
<p>到 10 月 13 日才进 Gemini 应用，全球开放，但只对 Google AI Pro 和 Ultra 订阅者。</p>
<p>价格方面，据多家媒体报道：API 介绍价是输入 2 美元 / 百万 token、输出 10 美元 / 百万 token，缓存输入打 95% 折（0.1 美元）。这个价格 11 月 30 日到期，之后回到 4 美元 / 20 美元，正好和 Claude Opus 5.5 持平。</p>
<h2>免费用户被砍了两刀</h2>
<p>第一刀在 10 月 9 日。个人账号的模型权限重新分层：</p>
<table>
<thead>
<tr>
<th>方案</th>
<th>能用什么</th>
</tr>
</thead>
<tbody>
<tr>
<td>未订阅</td>
<td>只有 Flash-Lite</td>
</tr>
<tr>
<td>AI Plus</td>
<td>Flash-Lite + Flash</td>
</tr>
<tr>
<td>AI Pro / Ultra</td>
<td>Flash-Lite + Flash + Pro（以及 Argon）</td>
</tr>
</tbody>
</table>
<p>以前免费账号偶尔能碰到的 Pro，现在要付费才有。Google 在支持文档里写得很直接：「从 2026 年 10 月起，个人账号使用 Gemini 应用时的模型可用性会有变化，先从没有订阅 AI 方案的用户开始生效。」</p>
<p>两点要注意。一是只管个人账号的网页版和 App，Gemini API、AI Studio、Workspace 不受影响。二是订阅用户也不是永远安全，撞到用量上限后会被降回 Flash-Lite 继续对话。Flash-Lite 现在成了所有人的兜底模型。</p>
<p>第二刀在 11 月 2 日，落在 Antigravity 上，下面单独说。</p>
<h2>Antigravity：模型明码分档</h2>
<p>Antigravity 是 Google 的 agent 编程平台，就是「反重力」，含桌面应用、CLI、IDE 扩展，免费就能下载。但能选哪个模型，完全看订阅档位。官方文档给得很直白：</p>
<table>
<thead>
<tr>
<th>模型</th>
<th>免费 / AI Plus</th>
<th>AI Pro</th>
<th>AI Ultra</th>
<th>Enterprise</th>
</tr>
</thead>
<tbody>
<tr>
<td>Gemini 4 Argon</td>
<td>不能</td>
<td>能（限正价 Pro）</td>
<td>能</td>
<td>能</td>
</tr>
<tr>
<td>Gemini 3.8 Flash</td>
<td>能</td>
<td>能</td>
<td>能</td>
<td>能</td>
</tr>
<tr>
<td>Gemini 3.7 / 3.6 Flash</td>
<td>不能</td>
<td>不能</td>
<td>不能</td>
<td>能</td>
</tr>
<tr>
<td>Gemini 3.1 Pro</td>
<td>不能</td>
<td>不能</td>
<td>不能</td>
<td>能</td>
</tr>
<tr>
<td>Claude Sonnet 5.5（思考版）</td>
<td>不能</td>
<td>能（限正价 Pro）</td>
<td>能</td>
<td>能</td>
</tr>
<tr>
<td>Claude Opus 5.5（思考版）</td>
<td>不能</td>
<td>能（限正价 Pro）</td>
<td>能</td>
<td>能</td>
</tr>
<tr>
<td>Claude Sonnet / Opus 4.6</td>
<td>能</td>
<td>能</td>
<td>不能</td>
<td>不能</td>
</tr>
<tr>
<td>GPT-OSS-120b</td>
<td>能</td>
<td>能</td>
<td>能</td>
<td>不能</td>
</tr>
</tbody>
</table>
<p>这张表里有三个坑。</p>
<p>第一个，低价 Pro 不算数。同样是 AI Pro，正价 Pro 和低价 Pro 的权限不一样：自己按月付正价订的，Argon 和 Claude 5.5 都能用；通过运营商捆绑、活动赠送、试用期拿到的低价 Pro，用不了。</p>
<p>官方文档的措辞是「Available on Google AI Pro for non-trial subscriptions only」，直译就是只对非试用订阅开放，后面还跟了一句：要从试用换成正价 Pro，得提交升级申请。所以低价 Pro 的账号在 Antigravity 里只会看到 Claude 4.6，Argon 和 Opus 5.5 都是灰的。这不是 bug，是规则。</p>
<p>低价 Pro 一般从四个渠道来：</p>
<ul>
<li>运营商捆绑。印度 Jio 的无限 5G 用户（月费 ₹349 及以上、年满 18 岁）可以免费领 18 个月的 AI Pro，官方给的估值是 ₹35,100，约 396 美元。</li>
<li>买手机赠送。买 Pixel 10 Pro / Pro XL / Pro Fold 送 12 个月 AI Pro（Pixel 9 Pro 系列同样有），需要在 2026 年 11 月 1 日前兑换；美国 Verizon 那边是买 Pixel 10 系列送 6 个月，之后每月 10 美元，正价 19.99 美元的一半。</li>
<li>学生优惠。2026 年 8 月 19 日起，美国大学生免费领 12 个月 AI Pro，其他 140 多个市场给 12 个月 AI Plus，需要过 SheerID 学籍验证。</li>
<li>免费试用。AI Pro 本身有一个月试用。</li>
</ul>
<p>这几种都挂着「AI Pro」的名头，但在 Antigravity 里一律按试用对待。名字一样，权限不一样。</p>
<p>第二个坑，Argon 在 Antigravity 的 IDE 里没有。文档标了星号：Argon 只在 Antigravity 桌面应用、CLI 和 IDE 扩展里可选，Antigravity IDE 本体反而用不了。</p>
<p>第三个，11 月 2 日会掉两个模型。Claude Sonnet / Opus 4.6 和 GPT-OSS-120b 都是「will be removed on November 2, 2026」。这两个正好是免费档和 AI Plus 现在唯二能用的非 Google 模型，下架之后，免费档就只剩 Gemini 3.8 Flash 一个选项了。</p>
<p>额度方面，Pro 和 Ultra 的配额每 5 小时刷新一次，另外还有周上限；Ultra 的档位是 100 美元一个月，容量是 Pro 的 5 倍。</p>
<h2>Gems 退场，skills 顶上</h2>
<p>配过 Gems 的人应该有印象：把一段常用指令存起来，下次直接调用。这个功能要被 skills 取代。</p>
<p>9 月 30 日 skills 上线，个人账号（18 岁以上）可用。官方会自动把你已有的 Gems 搬成 skills，不用手动重建。时间表是 2026 年 11 月起个人账号过渡，2027 年轮到工作 / 学校账号。</p>
<p>用法上有区别：在聊天框输入 <code>/</code>（之后会改成 <code>@</code>）加名字就能调用，Gemini 也会自己判断什么时候该用哪个，多个 skill 可以叠着用。</p>
<h2>企业侧：一个能进你邮箱干活的 agent</h2>
<p>10 月 8 日，Google Cloud 在 Gemini at Work 2026 上发布 Gemini agent：给一个目标，它在 Gmail、Drive、Docs、Slides、Sheets、Chat、Calendar 里自己把活干完，也能进 Slack 和 Microsoft 365。</p>
<p>两个设计值得记一下。一是「同事型 agent」有自己的 Workspace 账号、邮箱、日历和云盘，以它自己的身份行动，操作全部留日志。二是它会在多个模型之间按任务挑，配实时花费上限，据媒体报道，备选模型里也包括 Anthropic 的 Claude。</p>
<p>Google 给的数据：过去一年里，近 500 家 Google Cloud 客户各自处理了超过 1 万亿 token；约 80% 的 Cloud 客户在用它的 AI 产品；Fortune 100 里约 90% 在用 Gemini Enterprise。</p>
<h2>还有几件小的</h2>
<p>9 月，Gemini 3.8 Flash 上线，速度和成本与 3.7 持平；同时有面向安全场景的 3.8 Flash Cyber。</p>
<p>10 月 6 日，图像模型 Nano Banana 2.1 上线，底子是 Gemini 3.6 Flash。同一天 Google 发了一个免费的 Mac 应用（AI Edge Foresight），会议记录和整理都在本机跑，用 Gemma 4 和 EmbeddingGemma 2，不上云。</p>
<p>10 月 13 日，Antigravity 进了 Gemini 的 macOS 应用；设置里多了 Customize，能一次连 40 多个第三方应用，对所有档位开放。</p>
<p>10 月 20 日，Gemini 2.5 系列在 Google Cloud 的 Agent Platform 上停用，还在用的要换模型。</p>
<h2>引用来源</h2>
<ol>
<li>Gemini 应用发布说明（2026.10.13、09.30 等条目）：<a href="https://gemini.google/release-notes">https://gemini.google/release-notes</a></li>
<li>Gemini 4 Argon 官方发布稿：<a href="https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon">https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon</a></li>
<li>2026 年 9 月 AI 更新汇总（3.8 Flash、Live、TTS、Connected Apps 等）：<a href="https://blog.google/innovation-and-ai/technology/ai/google-ai-updates-september-2026">https://blog.google/innovation-and-ai/technology/ai/google-ai-updates-september-2026</a></li>
<li>Antigravity 模型可用性（按订阅档位，含 11 月 2 日下架与「非试用订阅」脚注，即正价 Pro 与低价 Pro 的区别）：<a href="https://antigravity.google/docs/models">https://antigravity.google/docs/models</a></li>
<li>Antigravity 方案与额度：<a href="https://antigravity.google/docs/plans">https://antigravity.google/docs/plans</a></li>
<li>Google Cloud：Gemini agent 发布（10 月 8 日）：<a href="https://cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026">https://cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026</a></li>
<li>Gems 转 skills 官方说明：<a href="https://support.google.com/gemini/answer/18560919">https://support.google.com/gemini/answer/18560919</a></li>
<li>Gemini 应用用量限额与方案：<a href="https://support.google.com/gemini/answer/16275805">https://support.google.com/gemini/answer/16275805</a></li>
<li>模型停用时间表（Nano Banana 2.1、Gemini 2.5 系列）：<a href="https://ai.google.dev/gemini-api/docs/deprecations">https://ai.google.dev/gemini-api/docs/deprecations</a></li>
<li>AI Edge Foresight 与 EmbeddingGemma 2：<a href="https://developers.googleblog.com/google-ai-edge-with-embeddinggemma-2/">https://developers.googleblog.com/google-ai-edge-with-embeddinggemma-2/</a></li>
<li>免费层模型权限调整（Google 支持文档，经媒体转引）：<a href="https://www.indiatoday.in/technology/news/story/google-is-changing-gemini-ai-plans-from-october-9-here-is-what-it-means-for-you-3009656-2026-10-05">https://www.indiatoday.in/technology/news/story/google-is-changing-gemini-ai-plans-from-october-9-here-is-what-it-means-for-you-3009656-2026-10-05</a></li>
<li>Jio 的 Google AI Pro 捆绑方案（18 个月免费，₹349 及以上 5G 套餐）：<a href="https://www.jio.com/google-gemini-offer">https://www.jio.com/google-gemini-offer</a></li>
<li>Pixel 购机赠送 AI Pro（Pixel 9 / 10 Pro 系列 12 个月，兑换截止 2026-11-01）：<a href="https://support.google.com/pixelphone/answer/13529884">https://support.google.com/pixelphone/answer/13529884</a></li>
<li>学生优惠（美国 AI Pro 12 个月，其他市场 AI Plus，SheerID 验证）：<a href="https://blog.google/innovation-and-ai/products/gemini-app/student-offer-google-ai">https://blog.google/innovation-and-ai/products/gemini-app/student-offer-google-ai</a></li>
<li>Argon 的 API 介绍价与恢复价（Google 官方脚注，经媒体转引）：<a href="https://medium.com/data-science-collective/gemini-4-argon-is-now-available-plans-price-and-how-it-compares-3064118baa8c">https://medium.com/data-science-collective/gemini-4-argon-is-now-available-plans-price-and-how-it-compares-3064118baa8c</a></li>
</ol>
<p>日期与数字均取自上述来源。标注「据报道」的部分为媒体转引，官方尚未在同一页面确认；榜单分数为厂商公布或第三方机构实测，不代表实际使用体验。</p>
]]></content>
    <author><name>林林</name></author>
    <category term="技术随笔"/>
  </entry>
  <entry>
    <title>换了套新系统</title>
    <link href="https://www.lxii.cc/posts/%E6%8D%A2%E4%BA%86%E5%A5%97%E6%96%B0%E7%B3%BB%E7%BB%9F/" rel="alternate" type="text/html"/>
    <id>https://www.lxii.cc/posts/%E6%8D%A2%E4%BA%86%E5%A5%97%E6%96%B0%E7%B3%BB%E7%BB%9F/</id>
    <published>2026-10-05T12:00:00.000Z</published>
    <updated>2026-10-05T12:00:00.000Z</updated>
    <summary>博客从旧系统搬到了新的一套：静态生成、构建即发布，顺手把该修的地方都修了一遍。</summary>
    <content type="html"><![CDATA[<h1>换了套新系统</h1>
<p>这里换了套新系统。</p>
<p>旧的那套用了挺久，功能不少，但改起来越来越费劲：调一个间距要翻三层配置，加一个页面得先搞明白它的模板继承关系。攒着攒着就成了「能跑，但不想碰」的状态。</p>
<p>新的这套走静态生成——构建一次出一份纯 HTML，服务器只负责把文件发出去。好处很直接：</p>
<ul>
<li><strong>打开快。</strong> 没有后端渲染，页面本身就是文件。</li>
<li><strong>改起来简单。</strong> 想改哪儿改哪儿，改完重新构建，一条命令的事。</li>
<li><strong>出问题好退。</strong> 每次发布都是独立版本，切回上一版只是改个软链接。</li>
</ul>
<p>搬的过程中顺手清了一批东西：主题自带的示例内容全删了，用不上的功能页关掉，导航、侧栏、标签重新理了一遍，以前文章里显示不对的日期也修了。</p>
<p>文章现在从头开始。旧的那些先归档放着，之后有空再慢慢挑回来。</p>
<p>就这样，慢慢更新。</p>
]]></content>
    <author><name>林林</name></author>
    <category term="生活随笔"/>
  </entry>
</feed>