DeepSeek 把压箱底的推理引擎开源了,硅谷为什么不跟
10 月 20 日,DeepSeek 把 DeepInfer 扔上了 GitHub,Apache 2.0。没有发布会,没有预热,跟去年 2 月那次开源周一个路数:一天一个仓库,扔完就走。
先说结论:这次开源的重量不在代码,在它顺手公开的那组运营数字。代码可以读,数字抄不走。
开的是生产引擎,不是 demo
README 第一句:这套东西在跑 DeepSeek 自己的大规模生产服务。
但它不是给人下载来玩的。只支持一个模型,V4.1-Flash;只支持两种硬件,NVIDIA SM100 和华为昇腾 950;要 CUDA 13 或 CANN 9.2,Python 3.12。官方 Q&A 写,最小的高效部署单元是 64 卡 prefill 加 64 卡 decode。
128 张 Blackwell。个人开发者看到这行可以关页面了。
它服务的对象很清楚:有卡、有集群、缺引擎的云厂商和大型推理团队。
开到了哪一层
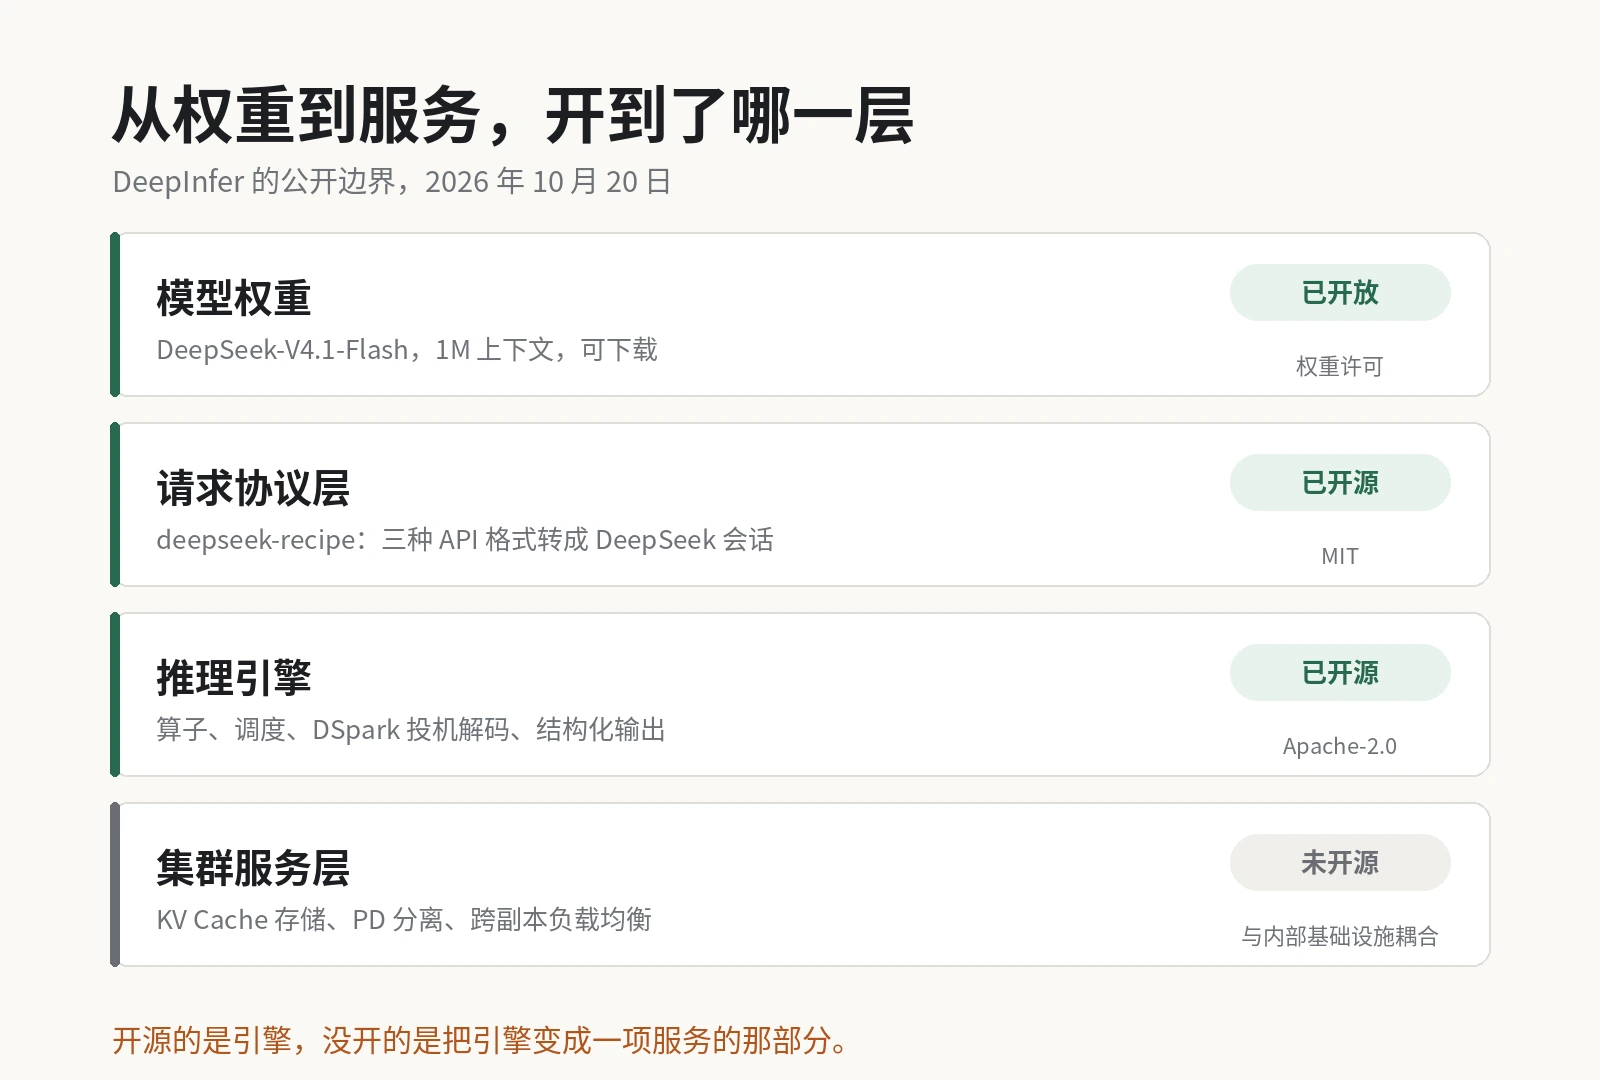
一起放的还有 deepseek-recipe,MIT 许可。它管请求怎么变成 token:Chat Completions、Responses、Messages 三种格式进来,统一成 DeepSeek 的会话,再把输出解析回去,包括思考内容、工具调用、图片。
两个许可都是宽松型,允许商用,也允许改了之后闭源。DeepSeek 没选 copyleft,等于放弃用许可证逼别人回馈。它要的是扩散速度,不是控制权。
两件事放一起看,边界就清楚了。模型权重早就开了,请求协议层这次开了,推理引擎这次开了。没开的是 KV Cache 存储、PD 分离的编排、跨副本负载均衡。
Q&A 里的原话是,这几块跟内部基础设施绑得太紧,“not yet fully open-sourced”。注意 yet。
翻译一下:它给你“把模型跑快”的能力,不给“把服务跑起来”的能力。前者是技术,后者是运营。技术可以送,运营不能送。
公开版还只是 offline inference。想拿它直接对外提供在线 API,中间那套得自己补。
这里有个容易被忽略的点:代码公开,不等于服务可以复现。那 100 PiB 的缓存怎么分层、哪些 prefix 值得留、什么时候淘汰、跨机房怎么调度,这些决策不在仓库里。参数可以照抄,判断不能。
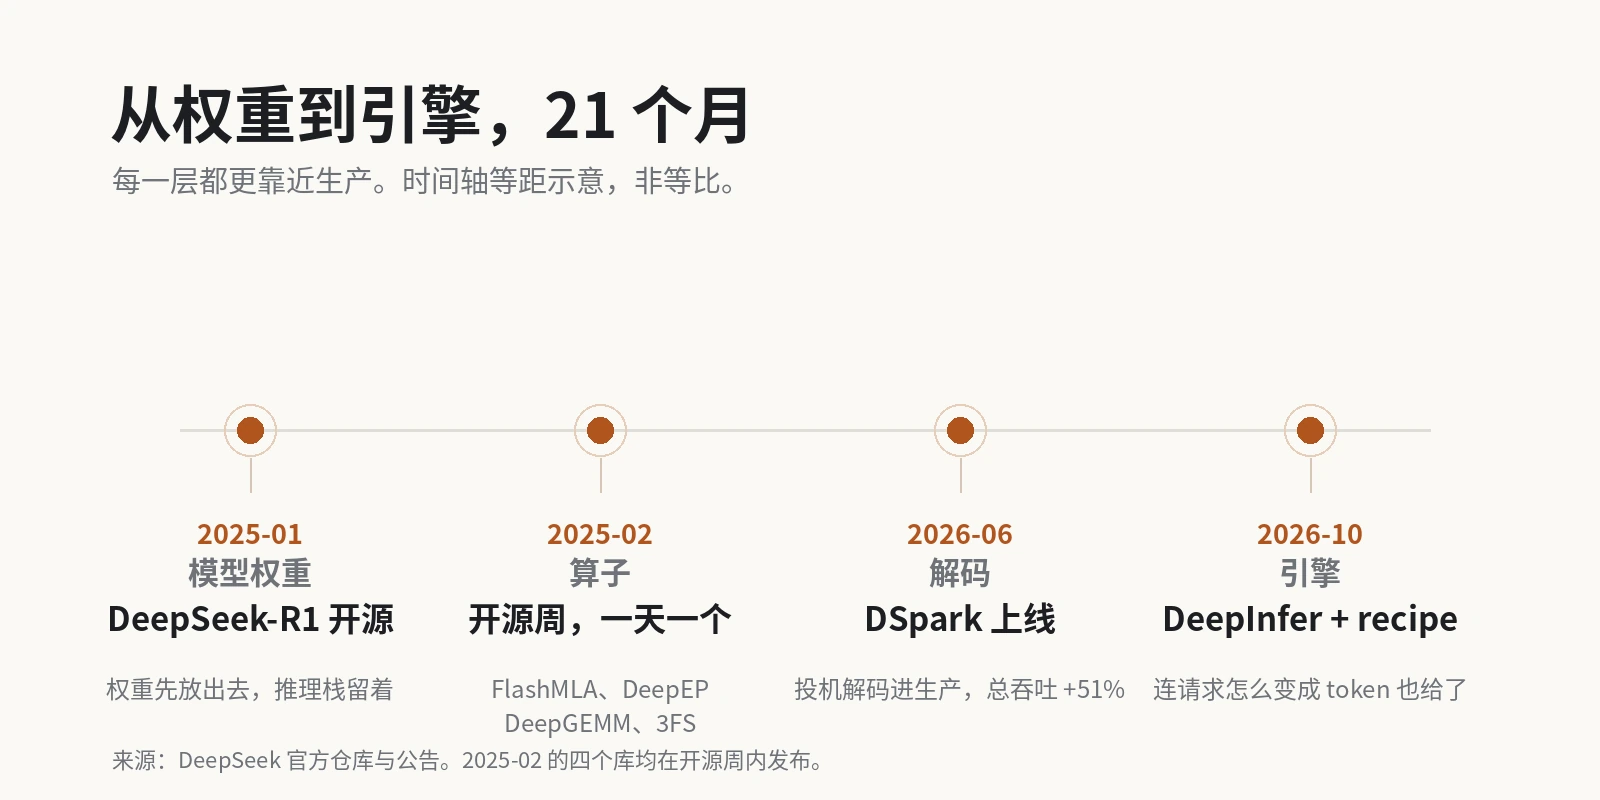
这不是一次性的动作。从权重到算子,再到引擎和协议层,DeepSeek 一层层往下开了 21 个月。
比代码值钱的是数字
Q&A 第一次公开了生产数据:
| 指标 | 数值 |
|---|---|
| 单集群吞吐 | 155 万亿 token/天 |
| 单卡收入 | 约 38 美元/GPU·小时(谷时价) |
| 平均首字延迟 | 400 ms |
| 生成速度 | 230 tok/s,代码场景 300 tok/s |
| 输入缓存命中率 | 96% |
| KV Cache 存储 | 约 100 PiB SSD |
| 每张在线 GPU 的逻辑缓存 | 约 14.4 TB |
38 美元是谷时电价下的口径,是下限。按 128 卡算,一小时 4864 美元。155 万亿 token 一天,折下来每秒约 18 亿 token。做推理生意的人看到这两个数,心里的秤就能校准。
还有两个细节。
缓存保留策略:agent 流量留 3 天,chatbot 流量留 7 天。因为 chatbot 的命中有一个很长的尾巴,少量缓存会被反复读很多次。这种经验不会写进论文。
公开版和内部版的差距:公开的 FlashMLA 少了一个手工调优,decode kernel 慢 5% 到 10%,端到端最多差 5%。这话很诚实,也说明真正拉开差距的,往往就是那一两个手调 kernel。
以上都是厂商口径,没有第三方复测。但愿意把每 GPU 小时收入写出来的公司,不多。
硅谷为什么不跟
先排除一个偷懒的解释:不是不会,也不是没东西可开。
OpenAI 去年开过 gpt-oss 的权重,Apache 2.0,单卡能跑。那是“让你在本地试试我们的模型”,不是“让你用我们的生产方式”。Anthropic 连权重都没开过。Meta 开了 Llama 权重,也没开生产栈。
Google 其实开过推理引擎。JetStream,跑在 XLA 设备上,Apache 2.0。今年 2 月 1 日归档,核心功能并进 vLLM 的 TPU 后端。这个动作比任何声明都说明问题:连 Google 都觉得,单独维护一个开源推理引擎,不如把它塞进社区最大的那个池子。
所以“美国闭源、中国开源”是个省事的说法。vLLM、SGLang、PyTorch、TensorRT-LLM,这些开源基建大多是美国高校和公司起头的。真正的区别是:美国巨头不开自己的生产栈。
原因不复杂。对 OpenAI 和 Anthropic,推理栈是毛利。模型能力落后半年还能追,单位成本落后 30% 追不回来。延迟、上下文长度、工具调用稳定性,这些产品体验最后都落在同一套栈上。开源等于把成本曲线交给对手,还附一份调优说明书。
闭源也不是纯坏话。工具调用约束、结构化输出、拒答策略,有一部分就长在推理栈上。开出去,别人能照着做,也能研究怎么绕。对把安全当卖点的公司,这笔账很难算平。
DeepSeek 的账不一样。权重本来就开,API 价格本来就低。推理栈捂着,护城河也护不住多少;放开,所有卖 DeepSeek 模型的云厂商都会按它的最优解跑。省下的调优时间,会变成更多 V4.1-Flash 部署。
这不是慈善,是标准战。Android 那套,先让所有人用你的底座,再谈别的。
我的判断是,引擎变成公共品之后,云厂商之间能比的只剩卡、电价和运维。推理服务的毛利会被压薄,钱往上游走,去卖卡、卖电、卖机房的人那里。DeepSeek 自己不做公有云,它乐见其成。
时间点也挑过。V4.1-Flash 是 9 月 10 日发的,到开源这天,口碑和调用量都起来了,引擎放出去接得住。再晚两个月,模型热度下去,代码开出来也没多少人部署。
昇腾那一行比 155 万亿更重
Supported hardware 只有两行:NVIDIA SM100 GPUs,Huawei Ascend 950 NPUs。
我在这行停了一会儿。
CUDA 的护城河不是指令集,是十年攒下来的算子、调度、调优经验。一颗新芯片最难的不是流片,是让框架作者愿意为它写 kernel,让云厂商相信它跑得稳。
一个生产级引擎把 SM100 和 Ascend 950 放在同一层抽象里,等于告诉所有用昇腾的人:你不用等一个国产推理框架慢慢成熟,DeepSeek 的生产引擎已经在你这边跑通了。
对英伟达不是好消息,对昇腾是,对开发者是多一个选择。虽然这个选择目前只支持一个模型。
能不能真跑起来,还得看后面有没有人提 PR。仓库现在 12k star、1.1k fork、92 个 PR,热度是真的,第三方生产验证还没有。
一个不刷榜的功能
引擎里有两个功能,跑分用不上,线上排障很要命:batch-invariant inference 和 deterministic sampling。
前者保证同一个请求放进不同 batch,结果一致(目前仅 NVIDIA)。后者保证固定种子和采样参数下,输出可复现。
做过线上服务的人知道这有多烦:用户投诉“同样的输入,你两次答得不一样”,你复现不出来,只能瞎猜。开了 batch-invariant,性能会掉一点,但至少能查。
一个只想刷榜的框架不会做这个。它做这个,说明它真被人半夜叫起来过。
聪明调度的拐点
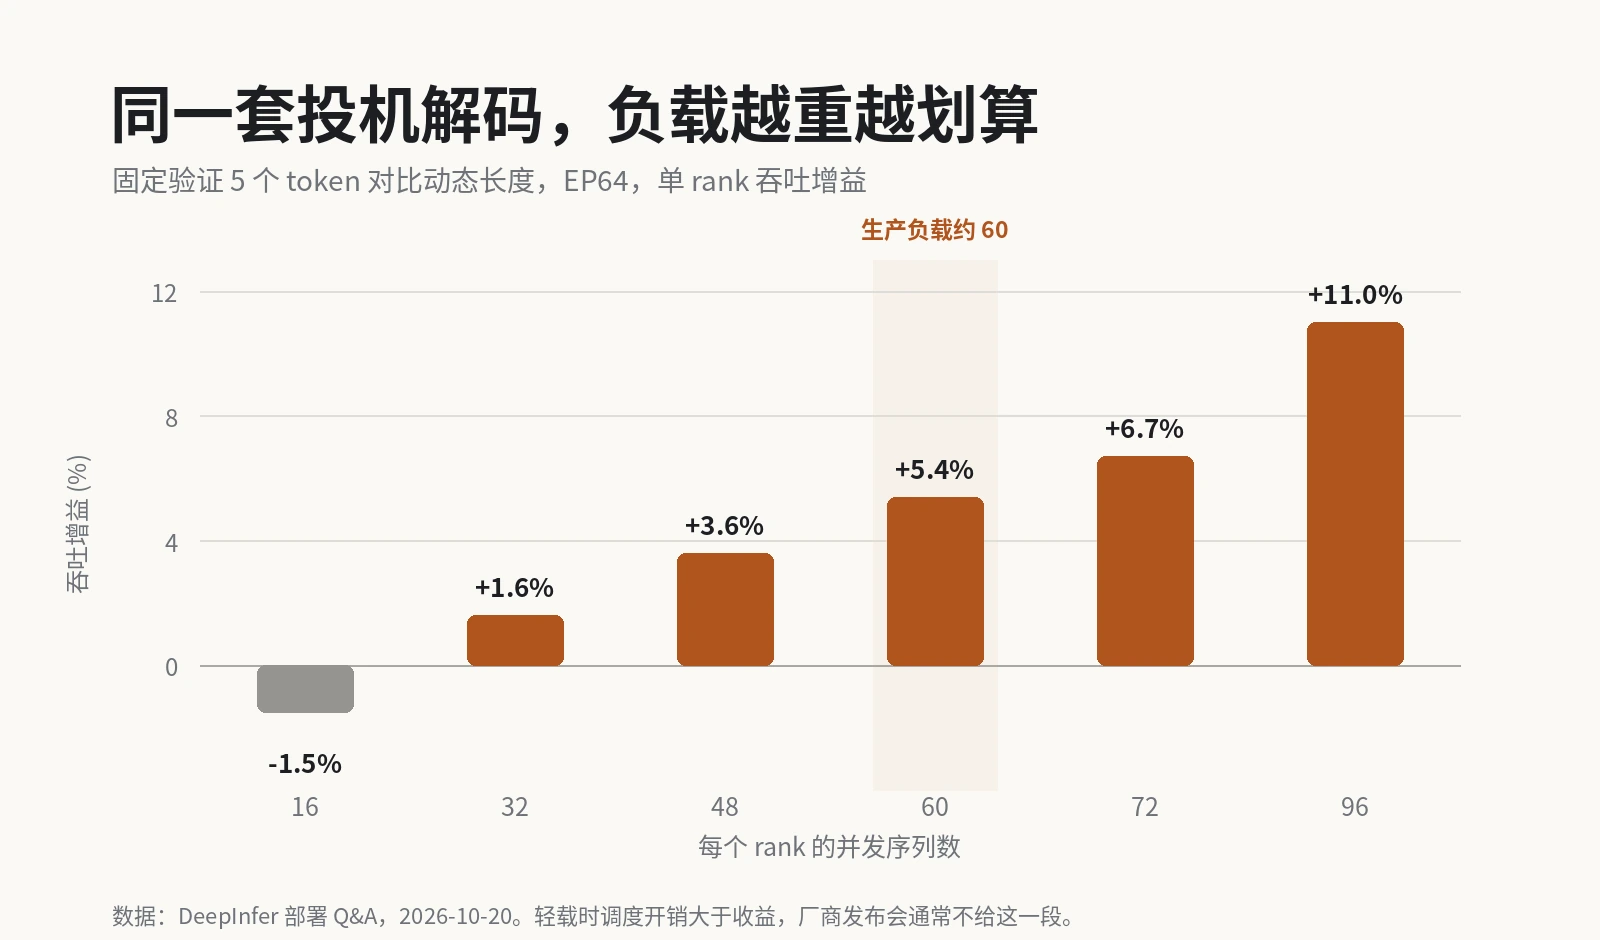
DSpark 是引擎里的投机解码方案。一次猜 5 个 token,再用 confidence head 估计每个被接受的概率,把验证算力花在更可能通过的那些上。
听起来全是好处。Q&A 给的表不太好看:
| 每 rank 并发 | 固定 5 个 | 动态长度 | 增益 |
|---|---|---|---|
| 16 | 4891 | 4816 | -1.5% |
| 32 | 8964 | 9111 | +1.6% |
| 48 | 12032 | 12467 | +3.6% |
| 60 | 13730 | 14466 | +5.4% |
| 72 | 14962 | 15961 | +6.7% |
| 96 | 16817 | 18660 | +11.0% |
轻载时是负收益。16 个并发,动态调度比固定长度慢 1.5%。生产负载 60 左右,增益 4% 到 7%。并发拉到 96,才有 11%。
这张表比任何“性能提升 XX%”的标题都有用。它告诉你拐点在哪,也告诉你什么时候别开这个开关。
厂商发布会只给你看峰值,Q&A 才会把负收益写出来。这份 Q&A 比代码值得读。
谁该用,谁别碰
有 128 张 SM100 或者 950 的云厂商、大厂推理团队:值得读,值得对着 Q&A 调。这是目前最接近 DeepSeek 官方答案的东西。
想省 API 费的中小团队:别碰。你缺的不是引擎,是 KV Cache 集群、PD 分离、负载均衡,还有那 100 PiB 的 SSD。自己搭一圈,成本大概率高于买 API。
个人开发者:读完 README 就够了。知道生产级长什么样,比在自己那张卡上跑起来有用。
它不是 vLLM 的替代品。只支持一个模型,换模型要改内核,公开版还是离线推理。它更像“DeepSeek 模型的最优解说明书”,不是“通用推理框架”。
DeepSeek 在 README 里承认,这套东西最早基于 vLLM,也参考了 SGLang 和 TensorRT-LLM。美国公司写的框架,成了中国公司生产引擎的起点;中国公司把引擎开出来,又回到同一个池子。这个循环挺有意思。
我的判断
三句话。
第一,这次开源不会让 DeepSeek 的 API 收入掉多少。够得着 128 卡门槛的人,本来就会自己买卡;够不着的人,看完只会更清楚为什么该买 API。开源在这里更像营销费用,不是收入让渡。
第二,竞争重心已经从“模型有多强”挪到“每个 token 多少钱”。谁先把成本曲线公开,谁就定义了价格锚。155 万亿和 38 美元这两个数,会比很多 benchmark 活得久。
第三,对美国巨头来说,最难回答的不是“你们为什么不开源”,而是“如果推理栈不再是秘密,你们还剩下什么”。
答案可能是产品、分发、信任,也可能什么都不是。这个我不知道。
代码在 GitHub 上,Apache 2.0。真想验证,先看 doc/inference_deployment_qa.md,那份 Q&A 比 README 实在。
引用来源
- DeepInfer 仓库(README、许可证、benchmark):https://github.com/deepseek-ai/DeepInfer
- DeepSeek,《Inference Deployment Q&A》(155 万亿、38 美元、128 卡、动态验证表格、缓存策略均出自此处):https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
- deepseek-recipe 仓库(MIT 许可、协议转换范围):https://github.com/deepseek-ai/deepseek-recipe
- 量子位,《刚刚,DeepSeek 开源自家推理框架!》(2026-10-20,首字延迟、生成速度、缓存命中率):https://m.sohu.com/a/1090300797_610300
- 36 氪,《DeepSeek:进一步将内部推理框架 DeepInfer 全面开源》(2026-10-20):https://36kr.com/newsflashes/4033986510099335
- CellCog,《DeepSeek Open-Sources DeepInfer: What It Takes to Run》(未开源组件、100 PiB、EP8/EP64 对比):https://cellcog.ai/blog/deepseek-deepinfer-open-source
- MarkTechPost,《DeepSeek Open-Sources DeepInfer, the Inference Framework Behind DeepSeek-V4.1-Flash》(2026-10-20):https://www.marktechpost.com/2026/10/20/deepseek-deepinfer-open-source-inference-framework
- VentureBeat,《DeepSeek open sources DSpark, a new framework to speed up LLM inference by up to 85%》(2026-06):https://venturebeat.com/ai/deepseek-open-sources-dspark-a-new-framework-to-speed-up-llm-inference-by-up-to-85
- openai/gpt-oss(Apache 2.0 开放权重):https://github.com/openai/gpt-oss
- google/JetStream(仓库公告:2026-02-01 归档,迁移至 tpu-inference):https://github.com/AI-Hypercomputer/JetStream
- vLLM:https://github.com/vllm-project/vllm
- SGLang:https://github.com/sgl-project/sglang
- NVIDIA TensorRT-LLM:https://github.com/NVIDIA/TensorRT-LLM
日期与数字取自上述来源。Q&A 中的生产数据为厂商口径,本文未独立复测。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 0 天
部分内容可能已过时